Menu
Votre produit doit-il utiliser l’IA ? Guide pratique

Muhammad Saeed
Ingénieur logiciel
19 juil. 2026
12 min de lecture
Un guide pratique pour les fondateurs qui choisissent entre IA, automatisation et logiciel standard : données, confidentialité, tests, coût et relecture humaine.
Sommaire10 sections
L’IA peut être utile dans un produit, mais « ajouter de l’IA » n’est pas une exigence produit. Partez du problème de l’utilisateur, de la décision que le logiciel doit soutenir et du coût d’une erreur sur cette décision.
La pression à adopter est réelle, et l’écart derrière elle aussi.
Le 2026 AI Index (s’ouvre dans un nouvel onglet) de Stanford HAI indique que l’adoption de l’IA par les organisations a atteint 88 % des organisations interrogées en 2025. Il note aussi que l’usage d’agents IA « reste précoce » dans presque toutes les fonctions de l’entreprise.
L’étude 2026 State of AI in the Enterprise (s’ouvre dans un nouvel onglet) de Deloitte a interrogé 3 235 dirigeants dans 24 pays. Elle relève que 74 % des organisations espèrent augmenter leur chiffre d’affaires grâce à l’IA, contre 20 % qui le font déjà.
L’adoption est presque universelle. La valeur réalisée ne l’est pas.
Cet écart justifie de ralentir le temps d’une conversation avant de s’engager. La question n’est pas de savoir si l’IA est capable. Elle est de savoir si cette fonctionnalité, pour cet utilisateur, correspond à un problème dont l’IA a la bonne forme.
Quand l’IA convient — et quand elle ne convient pas
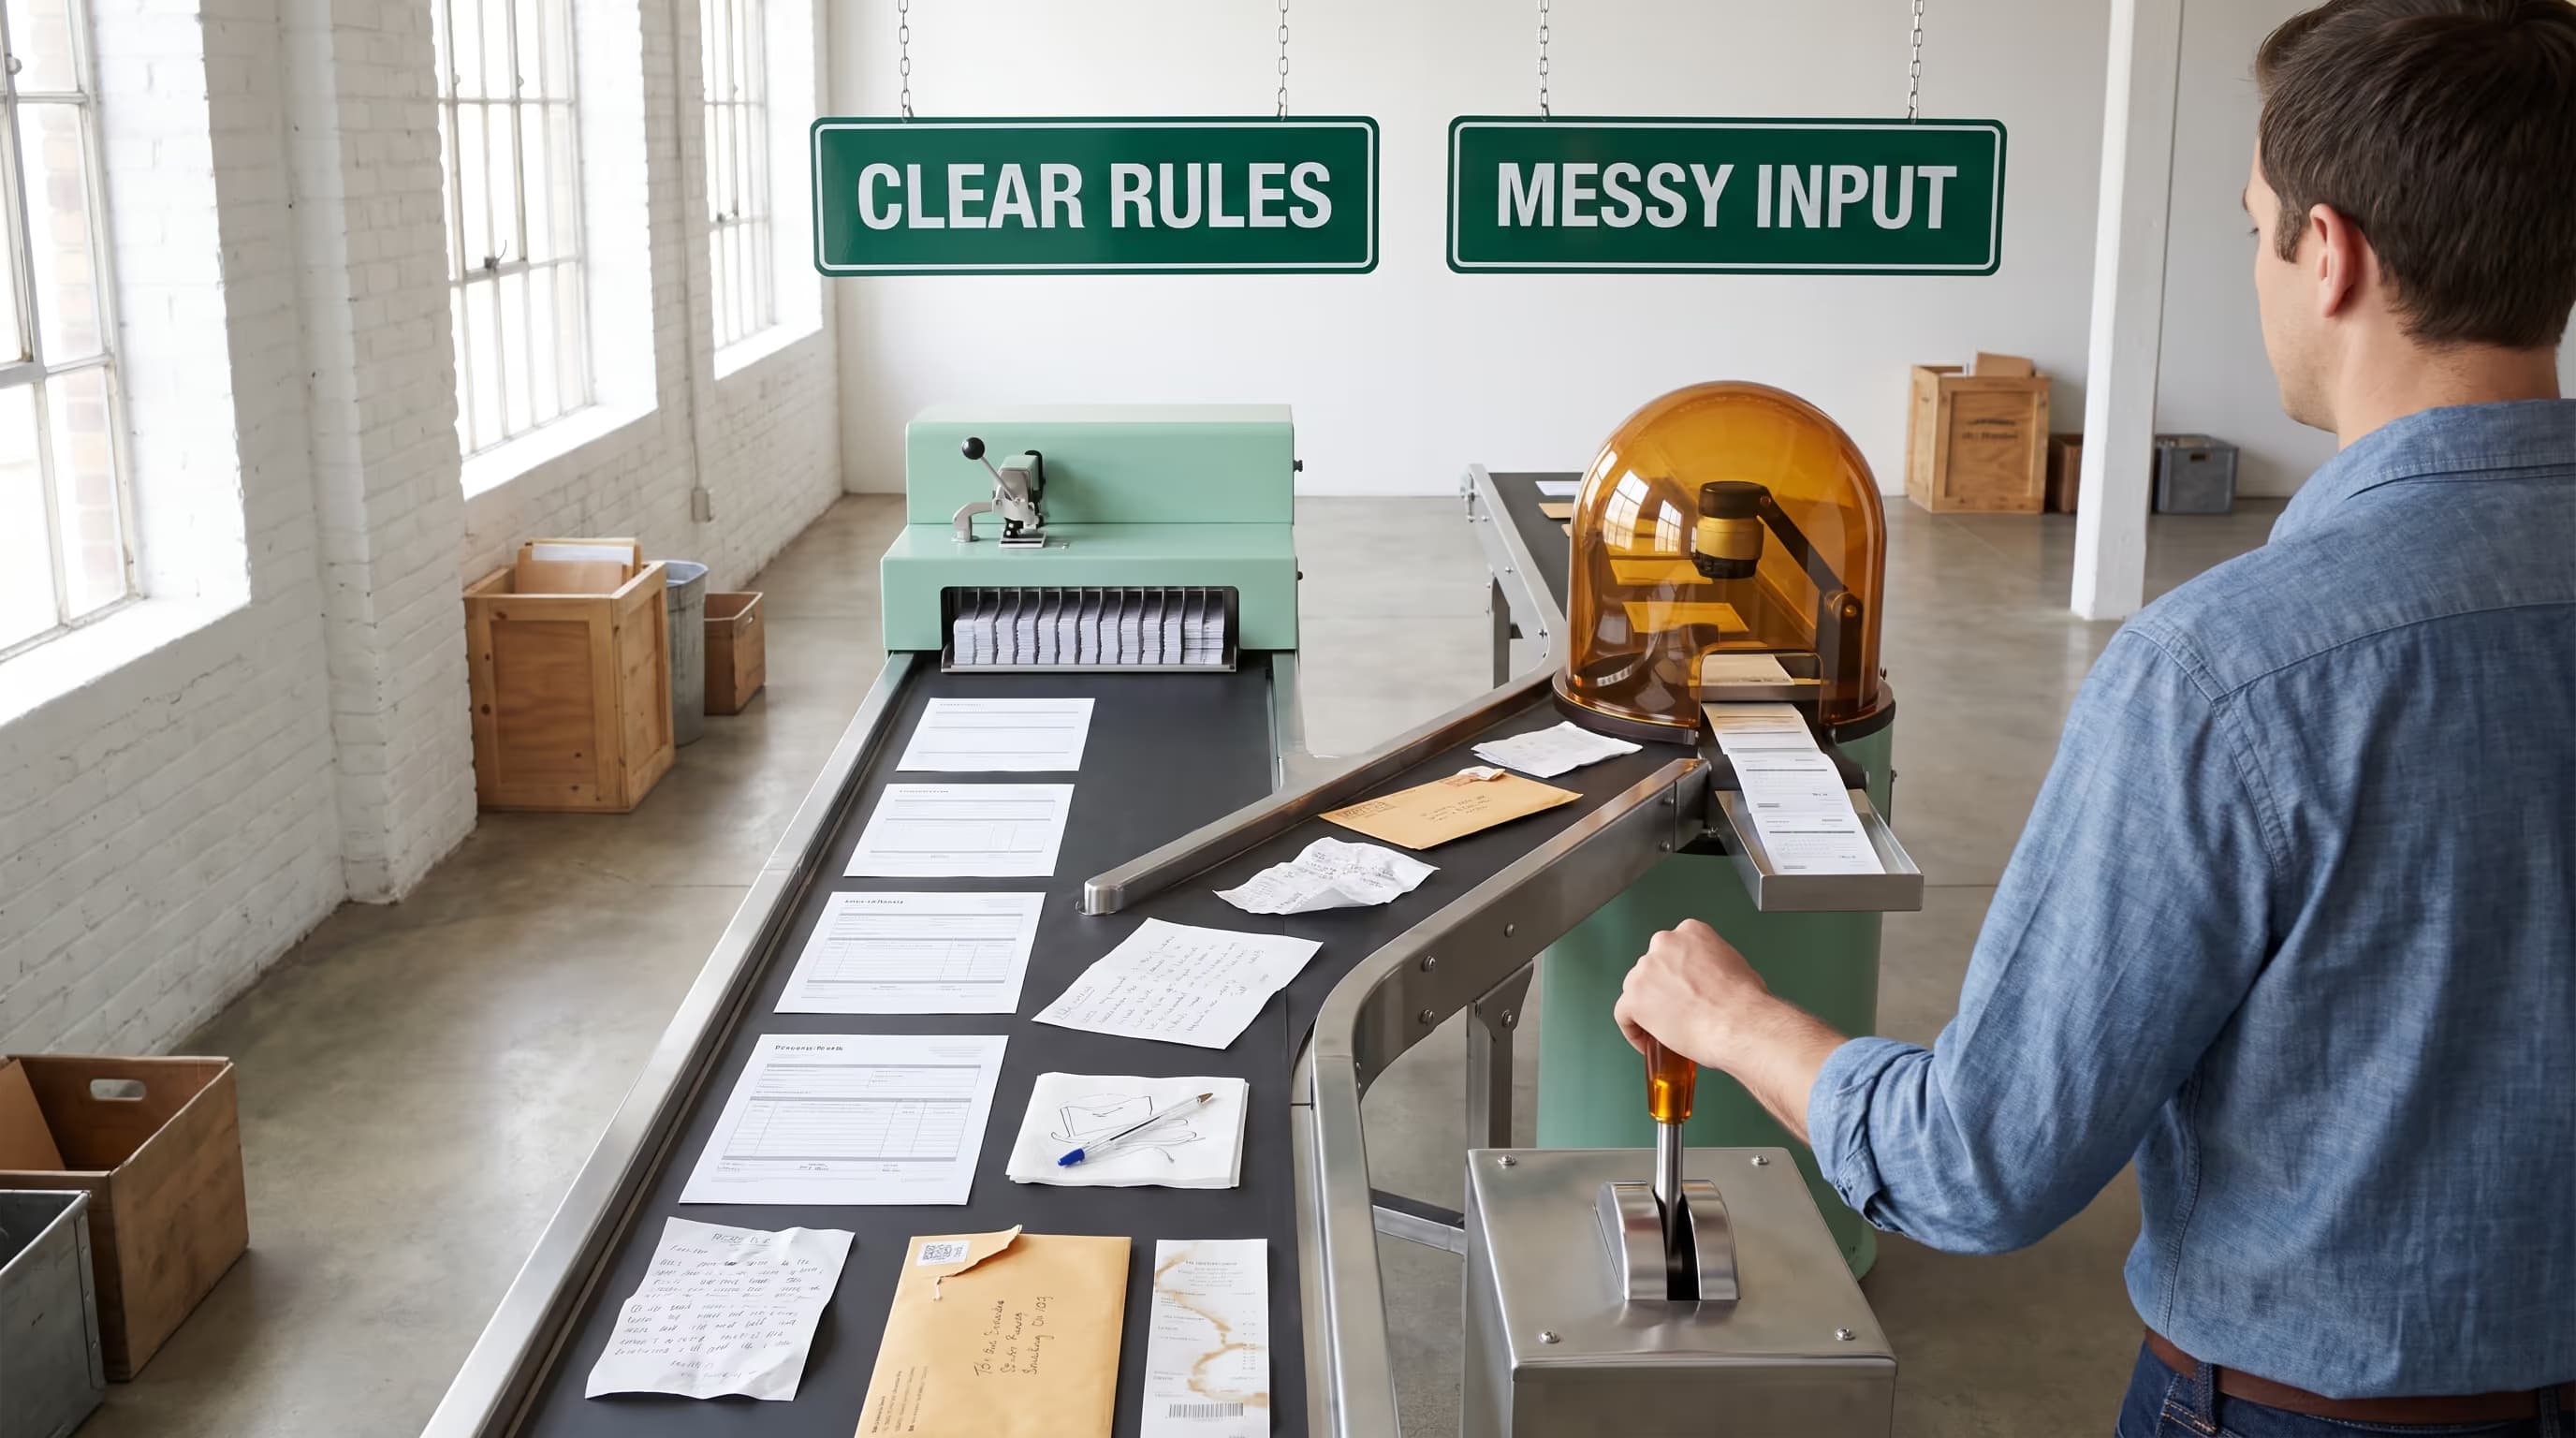
Un flux de travail classique est souvent le meilleur choix quand les règles sont claires. Formulaires, permissions, recherche, calculs, notifications et tâches planifiées n’ont pas besoin d’un modèle de langage simplement parce qu’il en existe un.
Ce n’est pas une position à contre-courant. Les Rules of Machine Learning (s’ouvre dans un nouvel onglet), les recommandations internes de Google pour les ingénieurs ML, s’ouvrent sur une instruction directe : « N’ayez pas peur de lancer un produit sans apprentissage automatique. »
Le raisonnement : une règle simple capte déjà une bonne part de la valeur. L’apprentissage automatique gagne sa place lorsque ces règles deviennent trop enchevêtrées à maintenir.
Un flux de travail conventionnel est généralement la meilleure réponse quand :
- les règles peuvent être écrites et validées par les responsables du processus
- la même entrée doit toujours produire la même sortie
- le coût d’une mauvaise réponse est élevé et la bonne peut être connue à l’avance
- quelqu’un doit pouvoir expliquer précisément pourquoi le système a fait ce qu’il a fait
- les données sont déjà structurées, validées et complètes
L’IA gagne sa place lorsque l’entrée est désordonnée, imprévisible ou difficile à cerner avec des règles fixes :
- résumer de longs documents, fils de discussion ou notes d’appel
- classer des messages en texte libre dont la formulation varie beaucoup
- extraire des champs de documents qui ne suivent jamais un modèle unique
- aider une personne à explorer l’information plutôt que décider à sa place
- rédiger une première version qu’un humain relira et modifiera
Le point commun de la seconde liste : un humain reste dans la boucle. La sortie est un brouillon, une suggestion ou un point de départ, pas une décision finale.
C’est généralement là que ces fonctionnalités gagnent d’abord leur place.
Commencez par la bonne question
La première question n’est pas « quel modèle utiliser ? » Demandez plutôt : « que doit pouvoir faire l’utilisateur, et où l’incertitude entre-t-elle dans le flux de travail ? » Cette réponse détermine si l’IA a sa place dans le produit.
Décidez à quoi ressemble un bon résultat avant de construire. Un résumé provisoire peut suffire avec une relecture humaine rapide. Une décision que le logiciel prend seul peut exiger des contrôles plus stricts, une explication claire et un moyen sûr de l’arrêter ou de la corriger.
L’AI Risk Management Framework (s’ouvre dans un nouvel onglet), publié en janvier 2023 comme cadre volontaire du NIST, le dit clairement. Parmi ses caractéristiques des systèmes dignes de confiance, être valide et fiable est « une condition nécessaire de la fiabilité ».
C’est la base sur laquelle reposent les autres caractéristiques. Une fonctionnalité impressionnante mais peu fiable n’a pas franchi la première barre.
Questions à poser avant de vous engager
Si quelqu’un propose une fonctionnalité IA, une courte liste de questions sépare généralement un plan réfléchi d’un plan enthousiaste :
- Quelle tâche cela accomplit-il, et comment la ferions-nous sans IA ?
- Que coûte une mauvaise réponse à l’utilisateur, et qui la remarque en premier ?
- Quelles données la fonctionnalité voit-elle, et où vont-elles ?
- Comment la testerons-nous avant le lancement, et à quelle fréquence ensuite ?
- Que fait le produit quand le modèle est indisponible ou incertain ?
- Combien cela coûte-t-il par utilisateur et par mois à dix fois le volume actuel ?
Aucune de ces questions n’exige un bagage technique. Toutes sont difficiles à trancher de façon convaincante sans lui.
Concevez pour la relecture humaine
La relecture humaine n’est pas une formule de sécurité vague. Donnez au relecteur assez de contexte pour vérifier la sortie, un moyen clair de la modifier et une voie pour signaler une défaillance que l’équipe produit pourra examiner.
Les cadres établis demandent une supervision que vous pouvez montrer par écrit, et non une supervision que vous comptez faire.
La fonction Map du cadre du NIST attend que « les processus de supervision humaine soient définis, évalués et documentés conformément aux politiques de l’organisation ».
Dans l’UE, Article 14 of the AI Act (s’ouvre dans un nouvel onglet) exige que les systèmes de sa catégorie à haut risque soient conçus de sorte « qu’ils puissent être effectivement supervisés par des personnes physiques pendant la période d’utilisation ».
Tous les produits n’entrent pas dans cette catégorie. Le principe de conception reste une valeur par défaut raisonnable bien avant de devenir une obligation légale.
Les recommandations de sécurité vont dans le même sens. L’OWASP Top 10 for LLM Applications (s’ouvre dans un nouvel onglet) classe Excessive Agency parmi ses risques 2025.
La mesure d’atténuation recommandée est directe : « recourez à un contrôle humain dans la boucle pour exiger qu’une personne approuve les actions à fort impact avant leur exécution ».
Si une fonctionnalité peut dépenser de l’argent, envoyer des messages ou modifier des enregistrements seule, cette étape d’approbation fait partie de la construction. Ce n’est pas une tâche de durcissement ultérieure.
Fixez les règles de données avant de construire
L’accès aux données et la confidentialité doivent faire partie de la conception. Identifiez quelles informations la fonctionnalité reçoit, où elles sont traitées, combien de temps elles sont conservées et quelles personnes ou systèmes peuvent accéder au résultat.
L’OWASP classe Sensitive Information Disclosure (s’ouvre dans un nouvel onglet) au deuxième rang de ses risques LLM 2025. Ses recommandations se résument à une règle que la plupart des équipes connaissent et négligent sous la pression : « limitez l’accès aux données sensibles selon le principe du moindre privilège ».
Le modèle est un système de plus ayant accès aux informations de vos utilisateurs, et il devrait être cadré comme tel.
Les fournisseurs publient des conditions concrètes, et elles diffèrent assez pour compter. Trois méritent une lecture avant de figer la conception :
- Usage pour l’entraînement. La documentation d’OpenAI sur les contrôles des données (s’ouvre dans un nouvel onglet) indique que « les données envoyées à l’API OpenAI ne servent pas à entraîner ou améliorer les modèles OpenAI », avec une fenêtre de conservation distincte pour la surveillance des abus.
- Conservation. La documentation d’Anthropic sur la conservation des données (s’ouvre dans un nouvel onglet) décrit la conservation nulle des données comme le fait que les prompts et les réponses ne sont pas stockés au repos après le renvoi de la réponse. Son propre tableau d’éligibilité marque les fonctionnalités à état comme des exceptions : la conservation nulle n’est donc pas générale.
- Où s’exécute l’inférence. La zone géographique est configurable et facturée séparément. La documentation d’Anthropic sur la résidence des données (s’ouvre dans un nouvel onglet) note qu’une inférence exclusivement aux États-Unis « est facturée 1,1 fois le tarif standard ».
Si le produit traite des données personnelles de personnes situées dans l’UE, l’obligation dès la conception est explicite.
Les orientations de la Commission européenne sur la protection des données dès la conception et par défaut (s’ouvre dans un nouvel onglet) indiquent que les organisations « devraient veiller à ce que les données à caractère personnel soient traitées avec le plus haut niveau de protection de la vie privée » par défaut.
C’est une décision prise avant l’intégration, pas après l’incident.
Prévoyez le coût par utilisateur
Ne supposez pas qu’un service d’IA hébergé est gratuit parce que la première expérimentation coûte peu. Usage, stockage, supervision, nouvelles tentatives, temps de relecture et futurs changements de modèle pèsent tous sur le coût d’exploitation.
Les fournisseurs d’IA facturent généralement la quantité de texte traitée : le coût croît donc avec l’usage plutôt qu’avec les effectifs.
Les leviers sont nommés dans la documentation tarifaire des fournisseurs (s’ouvre dans un nouvel onglet), à savoir : le choix du modèle, la mise en cache des prompts, le surcoût en jetons des appels d’outils et le traitement par lots. L’API Batch d’Anthropic offre « une remise de 50 % sur les jetons d’entrée et de sortie » pour le travail asynchrone.
Une fonctionnalité non rentable au tarif plein peut convenir quand le travail n’a pas besoin d’être immédiat.
Il y a aussi une dimension sécurité. L’entrée Unbounded Consumption (s’ouvre dans un nouvel onglet) de l’OWASP décrit comment « en déclenchant un grand nombre d’opérations, des attaquants exploitent le modèle de facturation à l’usage des services d’IA en nuage ».
On parle parfois de déni de portefeuille. Limites de débit, quotas et supervision de l’usage appartiennent à la première version, pas à la seconde.
Testez d’abord sur de vrais exemples
Constituez un petit jeu de test avant de déclarer la fonctionnalité prête. Utilisez des exemples représentatifs, incluez les cas difficiles et notez les types d’erreurs qui comptent pour les personnes qui utiliseront le produit.
Les deux grands fournisseurs traitent cela comme une chose que l’on fait d’abord, et non que l’on ajoute ensuite.
Les recommandations d’Anthropic sur le développement d’évaluations empiriques (s’ouvre dans un nouvel onglet) sont précises sur la forme d’un jeu utile : « soyez spécifique à la tâche : concevez des évaluations qui reflètent la distribution réelle de vos tâches. N’oubliez pas de tenir compte des cas limites ! »
La documentation d’OpenAI sur les évaluations (s’ouvre dans un nouvel onglet) présente la même pratique comme la compréhension de la performance d’une application par rapport aux attentes. C’est ce qui rend sûr le déploiement d’un changement de modèle ou de prompt.
Une évaluation utile n’a pas besoin de prédire chaque réponse. Elle doit montrer si la fonctionnalité est utile pour sa tâche, où elle échoue et quand le flux de travail doit rendre la main à une personne.
L’évaluation ne s’arrête pas non plus au lancement. Les recommandations de Microsoft sur l’observabilité (s’ouvre dans un nouvel onglet) décrivent un cycle de vie qui se poursuit en production avec « l’évaluation de la qualité et de la sécurité du trafic de production sur un échantillon ».
L’usage réel contiendra des entrées que votre jeu de test n’a jamais imaginées.
Prévoyez le repli
Un repli a lui aussi besoin d’une conception pratique. Si le modèle est indisponible, trop lent ou incertain, le produit doit quand même expliquer ce que l’utilisateur peut faire ensuite, au lieu de laisser un écran vide ou une réponse trompeuse.
Décidez à l’avance de ce que fait la fonctionnalité dans trois situations : quand le modèle ne renvoie rien d’exploitable, quand la requête expire et quand la confiance est faible.
Chacune est une décision produit aux conséquences visibles pour l’utilisateur. Chacune coûte moins cher maintenant que pendant un incident.
Il vaut aussi la peine de décider avec quelle facilité vous pourriez changer de modèle ou de fournisseur plus tard. Conserver les prompts, les jeux d’évaluation et une interface fine entre le produit et le modèle préserve cette option.
Un exemple concret
Pour rendre cela concret, imaginez une équipe de support submergée par les courriels entrants. Chaque message doit être lu, catégorisé et acheminé vers la bonne personne, et le volume a dépassé les capacités de l’équipe.
L’instinct est de se tourner vers un agent IA qui lit chaque courriel et y répond. Passez plutôt par les questions.
Quelle est la tâche, et comment la ferions-nous sans IA ? L’acheminement par mot-clé et par expéditeur traite déjà les cas clairs. Le difficile, ce sont les messages ambigus en texte libre — la forme qui convient à un modèle.
Que coûte une mauvaise réponse ? Un courriel mal acheminé coûte des minutes. Une réponse automatique qui invente une politique de remboursement coûte bien plus. La première version sûre suggère donc une catégorie et un brouillon ; c’est une personne qui envoie.
Comment la testerons-nous ? Quelques centaines de courriels déjà traités deviennent le jeu d’évaluation, en y incluant délibérément les cas désordonnés et inhabituels. Si la catégorie suggérée est juste assez souvent pour faire gagner du temps de lecture, elle gagne sa place.
La fonctionnalité livrée est étroite : classer et rédiger, un humain envoie, les règles par mot-clé traitent toujours les cas évidents, et tout est journalisé pour que le jeu d’évaluation continue de grandir.
C’est un produit plus petit, plus sûr et moins cher que l’agent imaginé au départ — et celui qui a le plus de chances de survivre au contact de vraies boîtes de réception.
Décider quoi construire
Utiliser l’IA pour construire quelque chose et livrer de l’IA à l’intérieur sont deux décisions distinctes. Un développeur peut utiliser des outils d’IA en écrivant le code et livrer malgré tout un produit qui fonctionne avec du logiciel ordinaire, avec des fonctions d’IA, ou avec les deux.
Pour un nouveau produit, décidez d’abord du plus petit flux de travail utile. N’ajoutez une fonctionnalité d’IA que si elle améliore ce flux pour un utilisateur défini et peut être testée avec des preuves que l’équipe saura maintenir.
Le plan produit IA le plus solide est précis sur ses limites. Il nomme la tâche, les données, le relecteur, le repli, la méthode d’évaluation et les hypothèses de coût avant que la fonctionnalité ne devienne une promesse.
Si vous arbitrez entre IA, automatisation et logiciel sur mesure, amenez la décision tôt dans la conversation de planification. La bonne réponse peut être l’IA, un flux à base de règles, ou aucune nouvelle technologie.
Recevoir le prochain article
Un e-mail quand un nouvel article paraît. Rien d’autre.
Je respecte votre vie privée. Désabonnement à tout moment.
Discussion
Commentaires
Aucun commentaire pour l’instant. Soyez le premier à donner votre avis.