Menú
¿Debería tu producto usar IA? Una guía práctica

Muhammad Saeed
Ingeniero de software
19 jul 2026
12 min de lectura
Una guía práctica para fundadores que eligen entre IA, automatización y software estándar, con preguntas sobre datos, privacidad, pruebas, coste y revisión humana.
Contenido10 secciones
La IA puede ser útil en un producto, pero «añadir IA» no es un requisito de producto. Empieza por el problema del usuario, la decisión que el software debe sostener y el coste de equivocarse en esa decisión.
La presión por adoptarla es real, y también lo es la brecha que hay detrás.
El 2026 AI Index (se abre en una pestaña nueva) de Stanford HAI informa de que la adopción de IA en las organizaciones llegó al 88 % de las organizaciones encuestadas en 2025. También señala que el uso de agentes de IA «sigue siendo incipiente» en casi todas las funciones de negocio.
El estudio 2026 State of AI in the Enterprise (se abre en una pestaña nueva) de Deloitte encuestó a 3.235 altos directivos en 24 países. Halló que el 74 % de las organizaciones espera aumentar ingresos con IA, frente al 20 % que ya lo hace.
La adopción es casi universal. El valor obtenido no lo es.
Esa brecha es la razón para frenar el tiempo de una conversación antes de comprometerse. La pregunta no es si la IA es capaz. Es si esta función, para este usuario, corresponde a un problema con la forma que la IA resuelve bien.
Cuándo encaja la IA y cuándo no
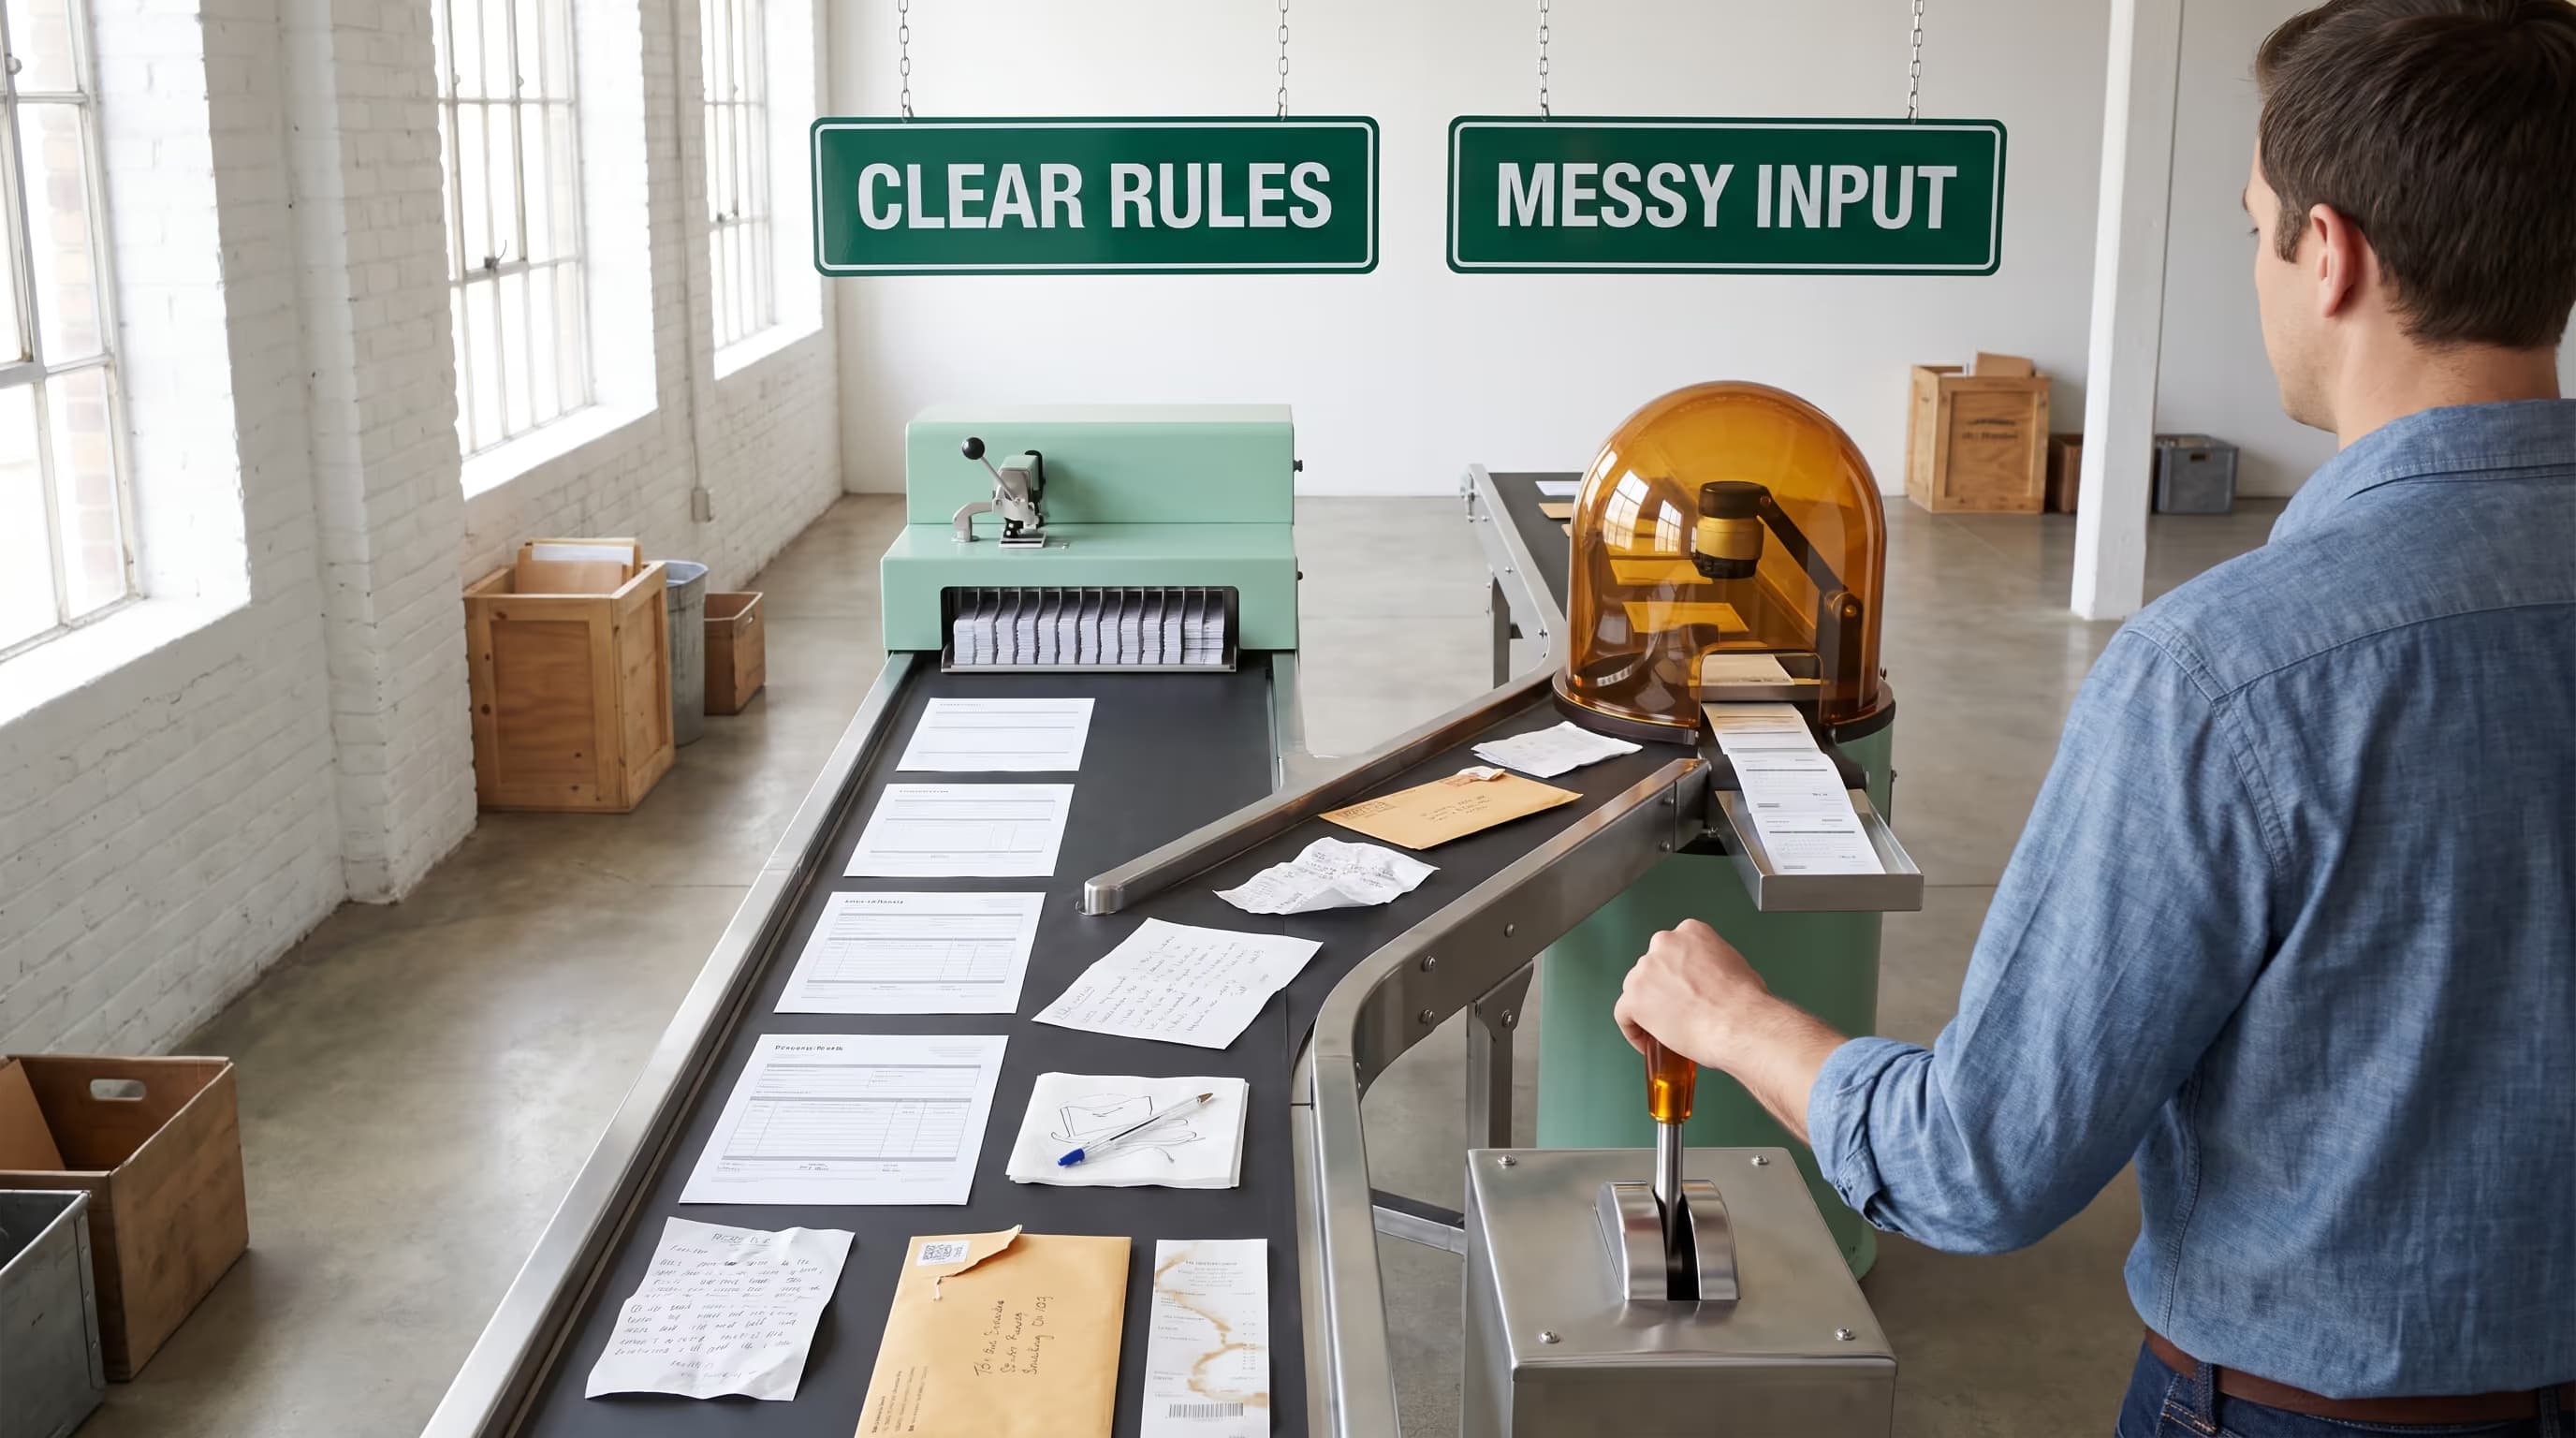
Un flujo de trabajo normal suele ser la mejor opción cuando las reglas son claras. Formularios, permisos, búsqueda, cálculos, notificaciones y tareas programadas no necesitan un modelo de lenguaje solo porque haya uno disponible.
No es una postura a contracorriente. Las Rules of Machine Learning (se abre en una pestaña nueva), la guía interna de Google para ingenieros de ML, se abren con una instrucción directa: «No tengas miedo de lanzar un producto sin aprendizaje automático».
El razonamiento es que una regla sencilla ya capta buena parte del valor. El aprendizaje automático se gana su lugar cuando esas reglas se enredan demasiado para mantenerlas.
Un flujo de trabajo convencional suele ser la mejor respuesta cuando:
- las reglas se pueden escribir y acordar con quienes son responsables del proceso
- la misma entrada debe producir siempre la misma salida
- el coste de una respuesta equivocada es alto y la correcta se puede conocer de antemano
- alguien necesita explicar con precisión por qué el sistema hizo lo que hizo
- los datos ya están estructurados, validados y completos
La IA se gana su lugar cuando la entrada es desordenada, impredecible o difícil de acotar con reglas fijas:
- resumir documentos largos, hilos o notas de llamadas
- clasificar mensajes de texto libre cuya redacción varía mucho
- extraer campos de documentos que nunca siguen una sola plantilla
- ayudar a una persona a explorar información en lugar de decidir por ella
- redactar una primera versión que un humano revisará y editará
El patrón de la segunda lista es que una persona permanece en el circuito. La salida es un borrador, una sugerencia o un punto de partida, no una decisión final.
Ahí es donde estas funciones suelen ganarse primero su lugar.
Empieza por la pregunta correcta
La primera pregunta no es «¿qué modelo usamos?». Pregunta más bien: «¿qué debe poder hacer el usuario y dónde entra la incertidumbre en el flujo de trabajo?». Esa respuesta determina si la IA pertenece al producto.
Decide cómo es un buen resultado antes de construir. Un resumen en borrador puede bastar con una comprobación humana rápida. Una decisión que el software toma solo puede necesitar controles más estrictos, una explicación clara y una forma segura de detenerla o corregirla.
El AI Risk Management Framework (se abre en una pestaña nueva), publicado en enero de 2023 como guía voluntaria del NIST, lo dice con claridad. Entre sus características de los sistemas fiables, ser válido y fiable es «una condición necesaria de la fiabilidad».
Es la base sobre la que descansan las demás características. Una función impresionante pero poco fiable no ha superado el primer listón.
Preguntas que hacer antes de comprometerte
Si alguien propone una función con IA, una lista corta de preguntas suele separar un plan meditado de uno entusiasta:
- ¿Qué tarea hace esto y cómo la haríamos sin IA?
- ¿Qué le cuesta al usuario una respuesta equivocada y quién la nota primero?
- ¿Qué datos ve la función y adónde van?
- ¿Cómo la probaremos antes del lanzamiento y con qué frecuencia después?
- ¿Qué hace el producto cuando el modelo no está disponible o no está seguro?
- ¿Cuánto cuesta esto por usuario y mes con diez veces el volumen actual?
Ninguna exige formación técnica para plantearla. Todas son difíciles de responder de forma convincente sin ella.
Diseña para la revisión humana
La revisión humana no es una fórmula vaga de seguridad. Da a quien revisa contexto suficiente para comprobar la salida, una forma clara de editarla y una vía para notificar un fallo que el equipo de producto pueda investigar.
Los marcos establecidos piden una supervisión que puedas señalar por escrito, no una que tengas intención de hacer.
La función Map del marco del NIST espera que «los procesos de supervisión humana se definan, evalúen y documenten conforme a las políticas de la organización».
En la UE, Article 14 of the AI Act (se abre en una pestaña nueva) exige que los sistemas de su categoría de alto riesgo se diseñen de modo «que puedan ser vigilados de manera efectiva por personas físicas durante el período en que estén en uso».
No todos los productos entran en esa categoría. El principio de diseño sigue siendo un valor por defecto razonable mucho antes de convertirse en uno legal.
La guía de seguridad coincide. El OWASP Top 10 for LLM Applications (se abre en una pestaña nueva) incluye Excessive Agency entre sus riesgos de 2025.
Su mitigación recomendada es directa: «utiliza control con intervención humana para exigir que una persona apruebe las acciones de alto impacto antes de ejecutarse».
Si una función puede gastar dinero, enviar mensajes o modificar registros por su cuenta, ese paso de aprobación forma parte de la construcción. No es una tarea posterior de refuerzo.
Fija las reglas de datos antes de construir
El acceso a los datos y la privacidad deben formar parte del diseño. Identifica qué información recibe la función, dónde se procesa, cuánto tiempo se conserva y qué personas o sistemas pueden acceder al resultado.
OWASP sitúa Sensitive Information Disclosure (se abre en una pestaña nueva) en segundo lugar entre sus riesgos de LLM de 2025. Su guía se reduce a una regla que la mayoría de los equipos conoce y omite bajo presión de plazos: «limita el acceso a los datos sensibles según el principio de mínimo privilegio».
El modelo es un sistema más con acceso a la información de tus usuarios, y debería acotarse como tal.
Los proveedores publican condiciones concretas, y difieren lo suficiente como para importar. Tres merecen una lectura antes de fijar el diseño:
- Uso para entrenamiento. La documentación de OpenAI sobre controles de datos (se abre en una pestaña nueva) indica que «los datos enviados a la API de OpenAI no se utilizan para entrenar ni mejorar los modelos de OpenAI», con una ventana de conservación aparte para la supervisión de abusos.
- Conservación. La documentación de Anthropic sobre conservación de datos (se abre en una pestaña nueva) describe la conservación cero de datos como que las peticiones y las respuestas no se almacenan en reposo después de devolverse la respuesta. Su propia tabla de elegibilidad marca las funciones con estado como excepciones, así que la conservación cero no es general.
- Dónde se ejecuta la inferencia. La geografía es configurable y se tarifica aparte. La documentación de Anthropic sobre residencia de datos (se abre en una pestaña nueva) señala que la inferencia exclusivamente en EE. UU. «se tarifica a 1,1 veces la tarifa estándar».
Si el producto trata datos personales de personas en la UE, la obligación en la fase de diseño es explícita.
Las orientaciones de la Comisión Europea sobre protección de datos desde el diseño y por defecto (se abre en una pestaña nueva) indican que las organizaciones «deben asegurar que los datos personales se traten con la máxima protección de la privacidad» por defecto.
Esa es una decisión que se toma antes de la integración, no después del incidente.
Planifica el coste por usuario
No supongas que un servicio de IA alojado es gratis porque el primer experimento sale barato. Uso, almacenamiento, supervisión, reintentos, tiempo de revisión y futuros cambios de modelo afectan al coste de operación.
Los proveedores de IA suelen cobrar por la cantidad de texto procesada, así que el coste crece con el uso y no con la plantilla.
Las palancas están nombradas en la propia documentación de precios de los proveedores (se abre en una pestaña nueva): elección de modelo, caché de peticiones, sobrecoste de tokens en llamadas a herramientas y procesamiento por lotes. La API Batch de Anthropic ofrece «un descuento del 50 % tanto en tokens de entrada como de salida» para trabajo asíncrono.
Una función que no sale rentable a precio completo puede estar bien cuando el trabajo no necesita ser inmediato.
También hay una dimensión de seguridad. La entrada Unbounded Consumption (se abre en una pestaña nueva) de OWASP describe cómo «al iniciar un alto volumen de operaciones, los atacantes explotan el modelo de coste por uso de los servicios de IA en la nube».
A esto se le llama a veces denegación de cartera. Los límites de tasa, las cuotas y la supervisión del uso pertenecen a la primera versión, no a la segunda.
Prueba primero con ejemplos reales
Crea un pequeño conjunto de pruebas antes de dar la función por lista. Usa ejemplos representativos, incluye casos difíciles y registra los tipos de error que importan a quienes van a usar el producto.
Los dos grandes proveedores lo tratan como algo que se hace primero, no como algo que se añade después.
Las orientaciones de Anthropic sobre el desarrollo de evaluaciones empíricas (se abre en una pestaña nueva) son concretas sobre la forma de un conjunto útil: «sé específico de la tarea: diseña evaluaciones que reflejen la distribución real de tus tareas. ¡No olvides tener en cuenta los casos límite!».
La documentación de OpenAI sobre evaluaciones (se abre en una pestaña nueva) plantea la misma práctica como entender cómo se comporta una aplicación frente a las expectativas. Eso es lo que hace seguro publicar un cambio de modelo o de petición.
Una evaluación útil no necesita predecir cada respuesta. Debe mostrar si la función es útil para su tarea, dónde falla y cuándo el flujo de trabajo debe devolver el control a una persona.
La evaluación tampoco se detiene en el lanzamiento. Las orientaciones de Microsoft sobre observabilidad (se abre en una pestaña nueva) describen un ciclo de vida que continúa en producción con «evaluación de calidad y seguridad del tráfico de producción a una tasa de muestreo».
El uso real contendrá entradas que tu conjunto de pruebas nunca imaginó.
Planifica la alternativa
La alternativa también necesita un diseño práctico. Si el modelo no está disponible, es demasiado lento o no está seguro, el producto debe seguir explicando qué puede hacer el usuario a continuación en vez de dejar un estado vacío o una respuesta engañosa.
Decide de antemano qué hace la función en tres situaciones: cuando el modelo no devuelve nada aprovechable, cuando la petición agota el tiempo y cuando la confianza es baja.
Cada una es una decisión de producto con consecuencias visibles para el usuario. Cada una es más barata ahora que durante un incidente.
También conviene decidir con qué facilidad podrías cambiar de modelo o de proveedor más adelante. Conservar las peticiones, los conjuntos de evaluación y una interfaz fina entre producto y modelo preserva esa opción.
Un ejemplo trabajado
Para concretarlo, imagina un equipo de soporte desbordado por el correo entrante. Cada mensaje hay que leerlo, clasificarlo y encaminarlo a la persona adecuada, y el volumen ha superado a quienes lo hacen.
El instinto es recurrir a un agente de IA que lea cada correo y responda. Pásalo mejor por las preguntas.
¿Cuál es la tarea y cómo la haríamos sin IA? El encaminamiento por palabra clave y remitente ya resuelve los casos claros. Lo difícil son los mensajes ambiguos de texto libre: justo la forma que le va bien a un modelo.
¿Qué cuesta una respuesta equivocada? Un correo mal encaminado cuesta minutos. Una respuesta automática que se inventa una política de reembolsos cuesta mucho más. Por eso la primera versión segura sugiere una categoría y un borrador; sigue enviando una persona.
¿Cómo la probaremos? Unos cientos de correos ya resueltos se convierten en el conjunto de evaluación, incluyendo a propósito los desordenados e inusuales. Si la categoría sugerida acierta lo bastante a menudo como para ahorrar tiempo de lectura, se gana su lugar.
La función que sale es estrecha: clasificar y redactar, envía una persona, las reglas por palabra clave siguen resolviendo los casos evidentes, y todo queda registrado para que el conjunto de evaluación siga creciendo.
Es un producto más pequeño, más seguro y más barato que el agente que el equipo imaginó primero, y el que tiene más probabilidades de sobrevivir al contacto con bandejas de entrada reales.
Decidir qué construir
Usar IA para construir algo y enviar IA dentro de ello son dos decisiones distintas. Alguien puede usar herramientas de IA mientras escribe el código y aun así entregar un producto que funcione con software normal, con funciones de IA, o con ambos.
Para un producto nuevo, decide primero el flujo de trabajo útil más pequeño. Añade una función de IA solo cuando mejore ese flujo para un usuario definido y pueda probarse con evidencia que el equipo sepa mantener.
El plan de producto con IA más sólido es concreto sobre sus límites. Nombra la tarea, los datos, quién revisa, la alternativa, el método de evaluación y los supuestos de coste antes de que la función se convierta en una promesa.
Si estás sopesando IA frente a automatización o software a medida, lleva la decisión pronto a la conversación de planificación. La respuesta correcta puede ser IA, un flujo basado en reglas o ninguna tecnología nueva.
Recibe el próximo artículo
Un correo cuando se publica un artículo nuevo. Nada más.
Respeto su privacidad. Puede darse de baja cuando quiera.
Debate
Comentarios
Todavía no hay comentarios. Sé la primera persona en opinar.