القائمة
هل ينبغي أن يستخدم منتجك الذكاء الاصطناعي؟ دليل عملي

محمد سعيد
مهندس برمجيات
19 يوليو 2026
9 دقائق قراءة
دليل عملي لمؤسسي الشركات الذين يختارون بين الذكاء الاصطناعي والأتمتة والبرمجيات القياسية، مع أسئلة عن البيانات والخصوصية والاختبار والتكلفة والمراجعة البشرية.
المحتويات10 أقسام
قد يكون الذكاء الاصطناعي مفيدًا داخل منتج، لكن «أضِف ذكاءً اصطناعيًا» ليس متطلبًا للمنتج. ابدأ من مشكلة المستخدم، ومن القرار الذي يجب أن تدعمه البرمجية، ومن تكلفة الخطأ في ذلك القرار.
الضغط نحو التبنّي حقيقي، والفجوة التي تقف خلفه حقيقية أيضًا.
يشير 2026 AI Index (يفتح في تبويب جديد) من ستانفورد HAI إلى أن تبنّي الذكاء الاصطناعي في المؤسسات ارتفع إلى 88% من المؤسسات المشمولة بالاستطلاع في 2025. ويلاحظ أيضًا أن استخدام وكلاء الذكاء الاصطناعي «لا يزال في بدايته» في كل وظيفة أعمال تقريبًا.
شمل 2026 State of AI in the Enterprise (يفتح في تبويب جديد) من ديلويت 3,235 من كبار القادة في 24 دولة. ووجد أن 74% من المؤسسات تأمل في زيادة إيراداتها عبر الذكاء الاصطناعي، مقابل 20% تفعل ذلك بالفعل.
التبنّي شبه شامل. أما القيمة المتحققة فلا.
تلك الفجوة هي سبب التمهّل بمقدار محادثة واحدة قبل الالتزام. والسؤال ليس ما إذا كان الذكاء الاصطناعي قادرًا، بل ما إذا كانت هذه الميزة، لهذا المستخدم، مشكلةً بالشكل الذي يناسبه الذكاء الاصطناعي.
متى يناسب الذكاء الاصطناعي ومتى لا يناسب
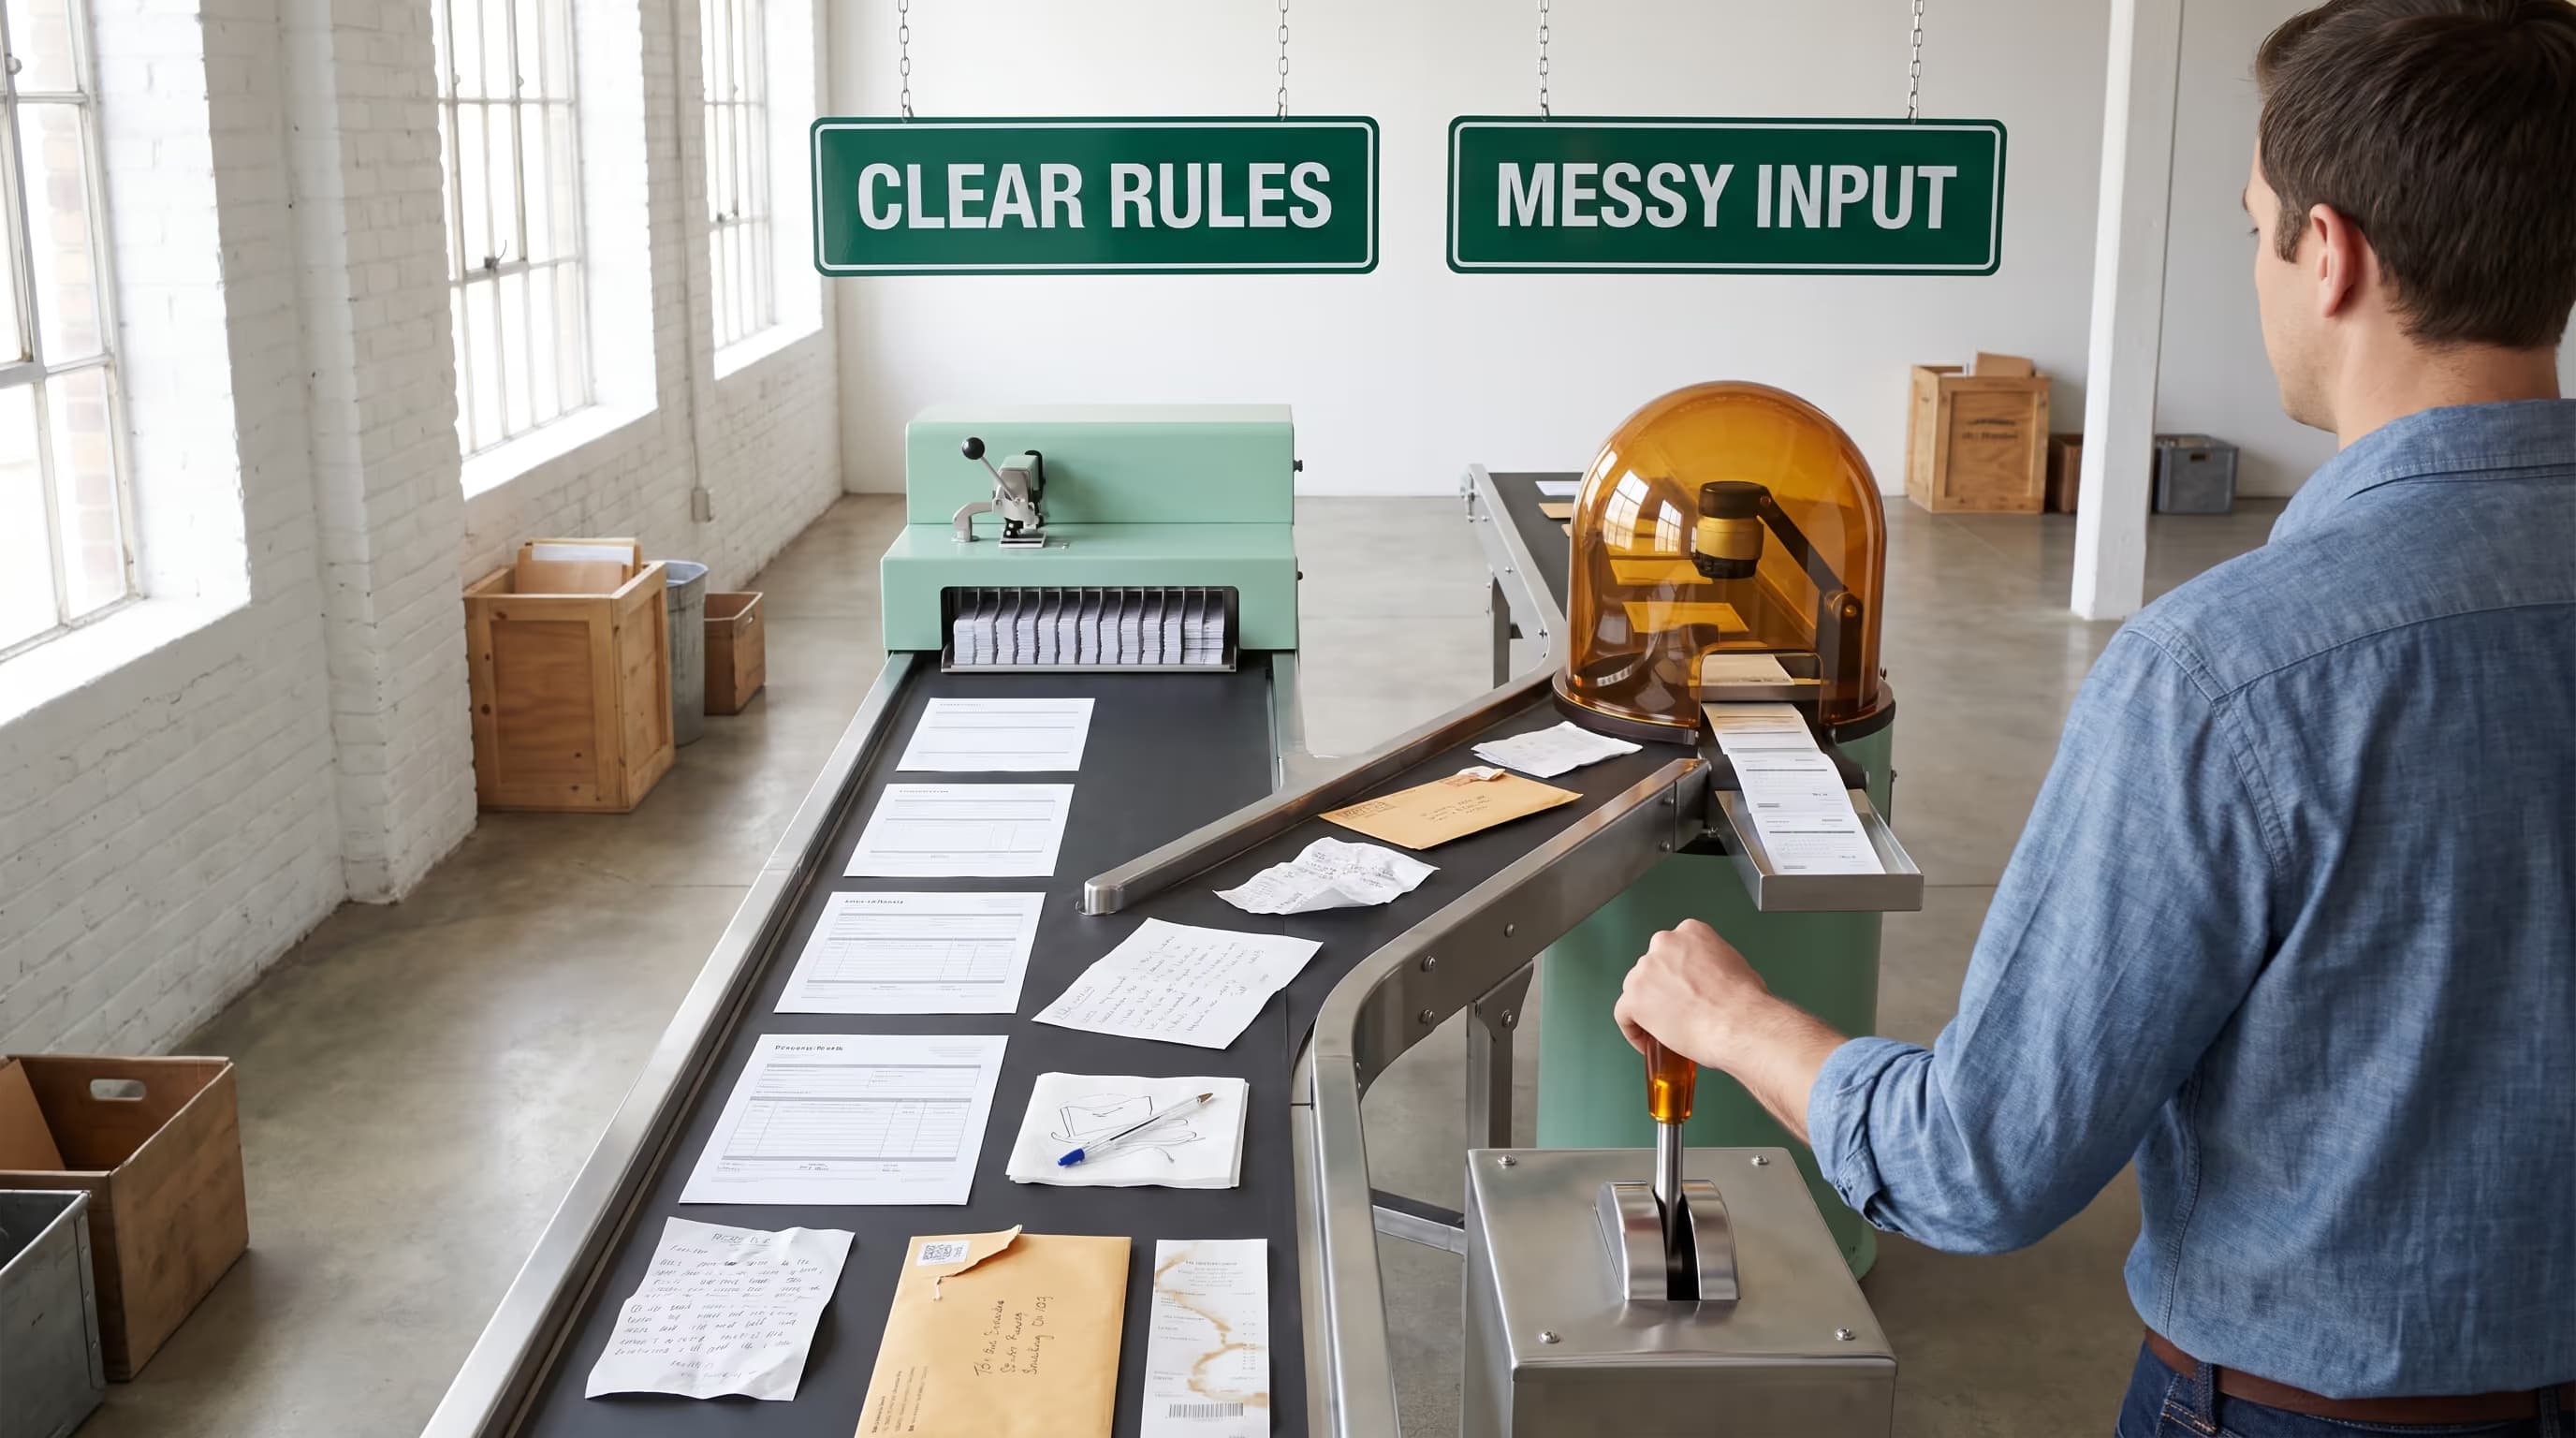
سير العمل المعتاد هو الخيار الأفضل غالبًا حين تكون القواعد واضحة. فالنماذج والصلاحيات والبحث والحسابات والإشعارات والمهام المجدولة لا تحتاج إلى نموذج لغوي لمجرد توفّره.
هذا ليس موقفًا مخالفًا للسائد. فوثيقة Rules of Machine Learning (يفتح في تبويب جديد)، وهي إرشادات Google الداخلية لمهندسي تعلّم الآلة، تبدأ بتعليمة مباشرة: «لا تخف من إطلاق منتج بلا تعلّم آلي».
والسبب أن قاعدة بسيطة تلتقط أصلًا جزءًا كبيرًا من القيمة. ويستحق تعلّم الآلة مكانه حين تصبح تلك القواعد أعقد من أن تُصان.
سير العمل التقليدي هو الإجابة الأفضل عادةً حين:
- يمكن كتابة القواعد والاتفاق عليها مع أصحاب العملية
- يجب أن يعطي المدخل نفسه المخرج نفسه دائمًا
- تكون تكلفة الإجابة الخاطئة عالية والإجابة الصحيحة معروفة مسبقًا
- يحتاج أحدهم إلى شرح دقيق لسبب قيام النظام بما قام به
- تكون البيانات منظّمة ومُتحقَّقًا منها وكاملة بالفعل
ويستحق الذكاء الاصطناعي مكانه حين يكون المدخل فوضويًا أو غير متوقع أو يصعب ضبطه بقواعد ثابتة:
- تلخيص مستندات طويلة أو سلاسل رسائل أو ملاحظات مكالمات
- تصنيف رسائل نصية حرّة تتباين صياغتها تباينًا واسعًا
- استخراج حقول من مستندات لا تتبع قالبًا واحدًا أبدًا
- مساعدة شخص على استكشاف المعلومات بدل أن يُقرَّر نيابةً عنه
- صياغة نسخة أولى يراجعها إنسان ويحرّرها
النمط المشترك في القائمة الثانية هو بقاء إنسان ضمن الحلقة. فالمخرج مسوّدة أو اقتراح أو نقطة انطلاق، لا قرارًا نهائيًا.
وهناك عادةً تكسب هذه الميزات مكانها أولًا.
ابدأ بالسؤال الصحيح
السؤال الأول ليس «أي نموذج نستخدم؟» بل اسأل: «ما الذي ينبغي أن يتمكّن المستخدم من فعله، وأين يدخل عدم اليقين إلى سير العمل؟» تلك الإجابة تحدّد ما إذا كان الذكاء الاصطناعي ينتمي إلى المنتج.
حدِّد شكل النتيجة الجيدة قبل أن تبني. فملخّص مسوّد قد يكفيه فحص بشري سريع، بينما قرار تتخذه البرمجية وحدها قد يحتاج ضوابط أشد، وتفسيرًا واضحًا، وطريقة آمنة لإيقافه أو تصحيحه.
تتناول وثيقة AI Risk Management Framework (يفتح في تبويب جديد)، الصادرة في يناير 2023 عن NIST كإرشادات طوعية، هذا الأمر بوضوح. فمن بين خصائص الأنظمة الجديرة بالثقة، يُعدّ كون النظام صالحًا وموثوقًا «شرطًا ضروريًا للجدارة بالثقة».
وهي الأساس الذي تقوم عليه بقية الخصائص. فالميزة المبهرة لكن غير الموثوقة لم تتجاوز العتبة الأولى.
أسئلة تطرحها قبل الالتزام
إذا اقترح أحدهم ميزة قائمة على الذكاء الاصطناعي، فإن قائمة أسئلة قصيرة تفصل عادةً الخطة المدروسة عن الخطة المتحمّسة:
- ما المهمة التي يؤديها هذا، وكيف كنا سننجزها بلا ذكاء اصطناعي؟
- ماذا تكلّف الإجابة الخاطئة المستخدم، ومن يلاحظها أولًا؟
- ما البيانات التي تطّلع عليها الميزة، وإلى أين تذهب؟
- كيف سنختبرها قبل الإطلاق، وكم مرة بعده؟
- ماذا يفعل المنتج حين يكون النموذج غير متاح أو غير واثق؟
- كم تكلّف هذه الميزة لكل مستخدم شهريًا عند عشرة أضعاف الحجم الحالي؟
لا يحتاج أيٌّ من هذه الأسئلة إلى خلفية تقنية لطرحه، لكنها جميعًا صعبة الإجابة بشكل مقنع من دونها.
صمّم للمراجعة البشرية
المراجعة البشرية ليست عبارة أمان غامضة. امنح المراجِع سياقًا كافيًا للتحقق من المخرج، وطريقة واضحة لتحريره، ومسارًا للإبلاغ عن خلل يستطيع فريق المنتج تقصّيه.
تطلب الأطر المعتمدة إشرافًا يمكنك الإشارة إليه مكتوبًا، لا إشرافًا تنوي القيام به.
تتوقع وظيفة Map في إطار NIST أن «تُحدَّد عمليات الإشراف البشري وتُقيَّم وتُوثَّق وفقًا لسياسات المؤسسة».
في الاتحاد الأوروبي، تشترط Article 14 of the AI Act (يفتح في تبويب جديد) أن تُصمَّم الأنظمة المدرجة في فئة المخاطر العالية بحيث «يمكن أن يشرف عليها أشخاص طبيعيون إشرافًا فعّالًا طوال فترة استخدامها».
وليس كل منتج يقع في تلك الفئة. غير أن مبدأ التصميم يبقى إعدادًا افتراضيًا معقولًا قبل أن يصير التزامًا قانونيًا بوقت طويل.
وإرشادات الأمن توافق على ذلك. إذ تُدرج OWASP Top 10 for LLM Applications (يفتح في تبويب جديد) بندَ Excessive Agency ضمن مخاطرها لعام 2025.
والإجراء الوقائي الموصى به مباشر: «استخدم تحكّمًا يُشرك الإنسان في الحلقة لاشتراط موافقة شخص على الإجراءات عالية الأثر قبل تنفيذها».
فإذا كانت ميزة ما قادرة وحدها على إنفاق المال أو إرسال الرسائل أو تغيير السجلات، فخطوة الموافقة تلك جزء من البناء، لا مهمة تحصين لاحقة.
ضع قواعد البيانات قبل البناء
يجب أن يكون الوصول إلى البيانات والخصوصية جزءًا من التصميم. حدّد ما المعلومات التي تتلقاها الميزة، وأين تُعالَج، وكم تُحفَظ، ومن من الأشخاص أو الأنظمة يجوز له الوصول إلى النتيجة.
يضع OWASP بندَ Sensitive Information Disclosure (يفتح في تبويب جديد) في المرتبة الثانية بين مخاطر نماذج اللغة لعام 2025. وتتلخّص إرشاداته في قاعدة تعرفها معظم الفرق وتتجاوزها تحت ضغط المواعيد: «قصر الوصول إلى البيانات الحسّاسة وفق مبدأ الامتياز الأدنى».
فالنموذج نظام إضافي يطّلع على معلومات مستخدميك، وينبغي تحديد نطاقه كما يُحدَّد نطاق أي نظام.
ينشر المزوّدون شروطًا محددة، وهي تختلف بما يكفي لتكون مهمة. وثلاثٌ منها تستحق القراءة قبل تثبيت التصميم:
- الاستخدام في التدريب. بحسب وثائق ضوابط البيانات لدى OpenAI (يفتح في تبويب جديد) فإن «البيانات المُرسَلة إلى واجهة OpenAI البرمجية لا تُستخدم لتدريب نماذج OpenAI أو تحسينها»، مع نافذة احتفاظ منفصلة لمراقبة إساءة الاستخدام.
- الاحتفاظ. تصف وثائق الاحتفاظ لدى Anthropic (يفتح في تبويب جديد) الاحتفاظ الصفري بالبيانات بأن المُوجّهات والردود لا تُخزَّن في حالة السكون بعد عودة الرد. وجدول الأهلية لديها يضع الميزات ذات الحالة كاستثناءات، فالاحتفاظ الصفري ليس شاملًا.
- أين يجري الاستدلال. الموقع الجغرافي قابل للضبط ويُسعَّر على حدة. وتشير وثائق إقامة البيانات لدى Anthropic (يفتح في تبويب جديد) إلى أن الاستدلال داخل الولايات المتحدة وحدها «يُسعَّر بـ1.1 ضعف السعر القياسي».
وإذا كان المنتج يعالج بيانات شخصية لأشخاص في الاتحاد الأوروبي، فإن الالتزام في مرحلة التصميم صريح.
أما إرشادات المفوضية الأوروبية بشأن حماية البيانات بالتصميم وبالإعداد الافتراضي (يفتح في تبويب جديد) فتنص على أن المؤسسات «ينبغي أن تضمن معالجة البيانات الشخصية بأعلى مستوى من حماية الخصوصية» افتراضيًا.
وذلك قرار يُتَّخذ قبل التكامل، لا بعد الحادثة.
خطّط للتكلفة لكل مستخدم
لا تفترض أن خدمة ذكاء اصطناعي مُستضافة مجانية لأن التجربة الأولى زهيدة. فالاستخدام والتخزين والمراقبة وإعادة المحاولات ووقت المراجعة وتغييرات النماذج المستقبلية تؤثر جميعها في تكلفة التشغيل.
يحاسب مزوّدو الذكاء الاصطناعي عادةً على كمية النص المعالَجة، فتنمو التكلفة مع الاستخدام لا مع عدد الموظفين.
وترد هذه العوامل في وثائق التسعير لدى المزوّدين (يفتح في تبويب جديد): اختيار النموذج، والتخزين المؤقت للمُوجّهات، وكلفة الرموز الإضافية لاستدعاءات الأدوات، والمعالجة الدُفعية. وتتيح واجهة Batch من Anthropic «خصمًا بنسبة 50% على رموز الإدخال والإخراج معًا» للأعمال غير المتزامنة.
والميزة غير المجدية اقتصاديًا بالسعر الكامل قد تكون مقبولة حين لا يلزم إنجاز العمل فورًا.
وهناك بُعد أمني أيضًا. إذ يصف بند Unbounded Consumption (يفتح في تبويب جديد) لدى OWASP كيف أن «المهاجمين، بإطلاق عدد كبير من العمليات، يستغلون نموذج الكلفة حسب الاستخدام في خدمات الذكاء الاصطناعي السحابية».
ويُسمّى هذا أحيانًا حرمان المحفظة. وحدود المعدل والحصص ومراقبة الاستخدام تنتمي إلى الإصدار الأول لا الثاني.
اختبر بأمثلة حقيقية أولًا
ابنِ مجموعة اختبار صغيرة قبل أن تعلن جاهزية الميزة. استخدم أمثلة ممثِّلة، وأدرج الحالات الصعبة، وسجّل أنواع الأخطاء التي تهمّ من سيستخدمون المنتج.
ويتعامل المزوّدان الكبيران مع هذا بوصفه شيئًا تفعله أولًا، لا شيئًا تضيفه لاحقًا.
وتتّسم إرشادات Anthropic حول تطوير التقييمات التجريبية (يفتح في تبويب جديد) بالتحديد في شكل المجموعة المفيدة: «كن محدَّد المهمة: صمّم تقييمات تعكس توزيع مهامك في الواقع. ولا تنسَ مراعاة الحالات الحدّية!».
بحسب دليل التقييمات لدى OpenAI (يفتح في تبويب جديد) فإن الممارسة نفسها تُعرض بوصفها فهمًا لأداء التطبيق مقابل التوقعات. وهذا ما يجعل تغيير النموذج أو المُوجّه آمنًا للإطلاق.
والتقييم المفيد لا يحتاج إلى التنبؤ بكل رد. بل ينبغي أن يبيّن ما إذا كانت الميزة مفيدة لمهمتها، وأين تخفق، ومتى يجب أن يعيد سير العمل التحكّم إلى شخص.
والتقييم لا يتوقف عند الإطلاق أيضًا. إذ تصف إرشادات Microsoft حول قابلية الملاحظة (يفتح في تبويب جديد) استمرار دورة الحياة إلى الإنتاج مع «تقييم الجودة والسلامة لحركة الإنتاج بمعدل عيّنة».
فالاستخدام الحقيقي سيتضمّن مدخلات لم تتخيّلها مجموعة اختبارك قط.
خطّط للبديل
البديل يحتاج أيضًا إلى تصميم عملي. فإذا كان النموذج غير متاح أو بطيئًا جدًا أو غير واثق، ينبغي أن يظل المنتج قادرًا على شرح ما يمكن للمستخدم فعله تاليًا بدل ترك شاشة فارغة أو إجابة مضلِّلة.
قرّر مسبقًا ما تفعله الميزة في ثلاث حالات: حين لا يعيد النموذج شيئًا صالحًا للاستخدام، وحين تنتهي مهلة الطلب، وحين تكون الثقة منخفضة.
كل حالة قرار منتج بعواقب مرئية للمستخدم، وكل واحدة أرخص الآن مما هي أثناء حادثة.
ويجدر أيضًا أن تقرّر مدى سهولة تغيير النموذج أو المزوّد لاحقًا. فالاحتفاظ بالمُوجّهات ومجموعات التقييم وواجهة رفيعة بين المنتج والنموذج يحفظ ذلك الخيار.
مثال مُطبَّق
لجعل الأمر ملموسًا، تخيّل فريق دعم يغرق في البريد الوارد. كل رسالة يجب أن تُقرأ وتُصنَّف وتُوجَّه إلى الشخص المناسب، وقد فاق الحجم قدرة من يقومون بذلك.
والاندفاع الأول هو اللجوء إلى وكيل ذكاء اصطناعي يقرأ كل رسالة ويردّ. مرّرها على الأسئلة بدلًا من ذلك.
ما المهمة، وكيف كنا سننجزها بلا ذكاء اصطناعي؟ التوجيه بالكلمة المفتاحية والمُرسِل يعالج الحالات الواضحة أصلًا. الصعب هو الرسائل النصية الحرّة الملتبسة — وهو الشكل الذي يناسب نموذجًا.
ماذا تكلّف الإجابة الخاطئة؟ رسالة موجَّهة خطأً تكلّف دقائق، أما رد آلي يخترع سياسة استرداد فيكلّف أكثر بكثير. لذلك تقترح النسخة الأولى الآمنة تصنيفًا ومسوّدة؛ ويظل الإرسال بيد شخص.
كيف سنختبرها؟ بضع مئات من الرسائل المُعالَجة سابقًا تصبح مجموعة التقييم، مع تضمين الفوضوية وغير المعتادة عمدًا. وإذا كان التصنيف المقترح صحيحًا بما يكفي لتوفير وقت القراءة، فقد كسب مكانه.
الميزة التي تُطلَق ضيّقة: تصنيف وصياغة، والإرسال بيد إنسان، وقواعد الكلمات المفتاحية تظل تعالج الحالات البديهية، وكل شيء يُسجَّل لتستمر مجموعة التقييم في النمو.
وهذا منتج أصغر وأأمن وأرخص من الوكيل الذي تخيّله الفريق أولًا — وهو الأرجح بقاءً عند الاحتكاك بصناديق بريد حقيقية.
تقرير ما ستبنيه
استخدام الذكاء الاصطناعي في البناء وشحنه داخل المنتج قراران مختلفان. فقد يستخدم المطوّر أدوات ذكاء اصطناعي أثناء كتابة الشيفرة، ويسلّم مع ذلك منتجًا يعمل ببرمجيات عادية، أو بميزات ذكاء اصطناعي، أو بكليهما.
في منتج جديد، قرّر أولًا أصغر سير عمل مفيد. ولا تضف ميزة ذكاء اصطناعي إلا حين تحسّن ذلك السير لمستخدم محدَّد ويمكن اختبارها بأدلة يقدر الفريق على صيانتها.
وأقوى خطة لمنتج بالذكاء الاصطناعي هي التي تحدّد حدودها بدقة. فهي تسمّي المهمة والبيانات والمراجِع والبديل وطريقة التقييم وافتراضات التكلفة قبل أن تتحول الميزة إلى وعد.
وإذا كنت توازن بين الذكاء الاصطناعي والأتمتة أو البرمجيات المخصّصة، فاطرح القرار مبكرًا في محادثة التخطيط. فقد يكون الجواب الصحيح ذكاءً اصطناعيًا، أو سير عمل قائمًا على قواعد، أو لا تقنية جديدة على الإطلاق.
احصل على المقال التالي
رسالة واحدة عند نشر مقال جديد. لا شيء غير ذلك.
أحترم خصوصيتك. يمكنك إلغاء الاشتراك في أي وقت.
نقاش
التعليقات
لا توجد تعليقات بعد. كن أول من يشارك رأيه.