メニュー
あなたのプロダクトにAIは必要か——実務的な手引き

ムハンマド・サイード
ソフトウェアエンジニア
2026年7月19日
約14分で読めます
AI、自動化、通常のソフトウェアのあいだで迷う創業者のための実務的な手引き。データ、プライバシー、テスト、費用、人による確認について問うべきことをまとめます。
目次10セクション
AIはプロダクトの中で役に立ちますが、「AIを載せる」ことは要件ではありません。利用者の課題、ソフトウェアが支えるべき判断、その判断を誤ったときの代償から始めてください。
導入への圧力は本物です。そしてその背後にある差も本物です。
スタンフォードHAIの 2026 AI Index (新しいタブで開きます) は、組織におけるAI導入が2025年に調査対象組織の88%まで上昇したと報告しています。またAIエージェントの利用は、ほぼすべての業務機能で「まだ初期段階にある」とも述べています。
デロイトの 2026 State of AI in the Enterprise (新しいタブで開きます) は24か国3,235名の上級リーダーを対象に調査しました。74%の組織がAIによる増収を期待している一方、実際に実現しているのは20%でした。
導入はほぼ普遍的です。得られた価値はそうではありません。
その差こそ、決める前に一度だけ立ち止まって話し合う理由です。問うべきはAIに能力があるかではなく、この機能がこの利用者にとって、AIという形に合った課題なのかどうかです。
AIが合う場合と合わない場合
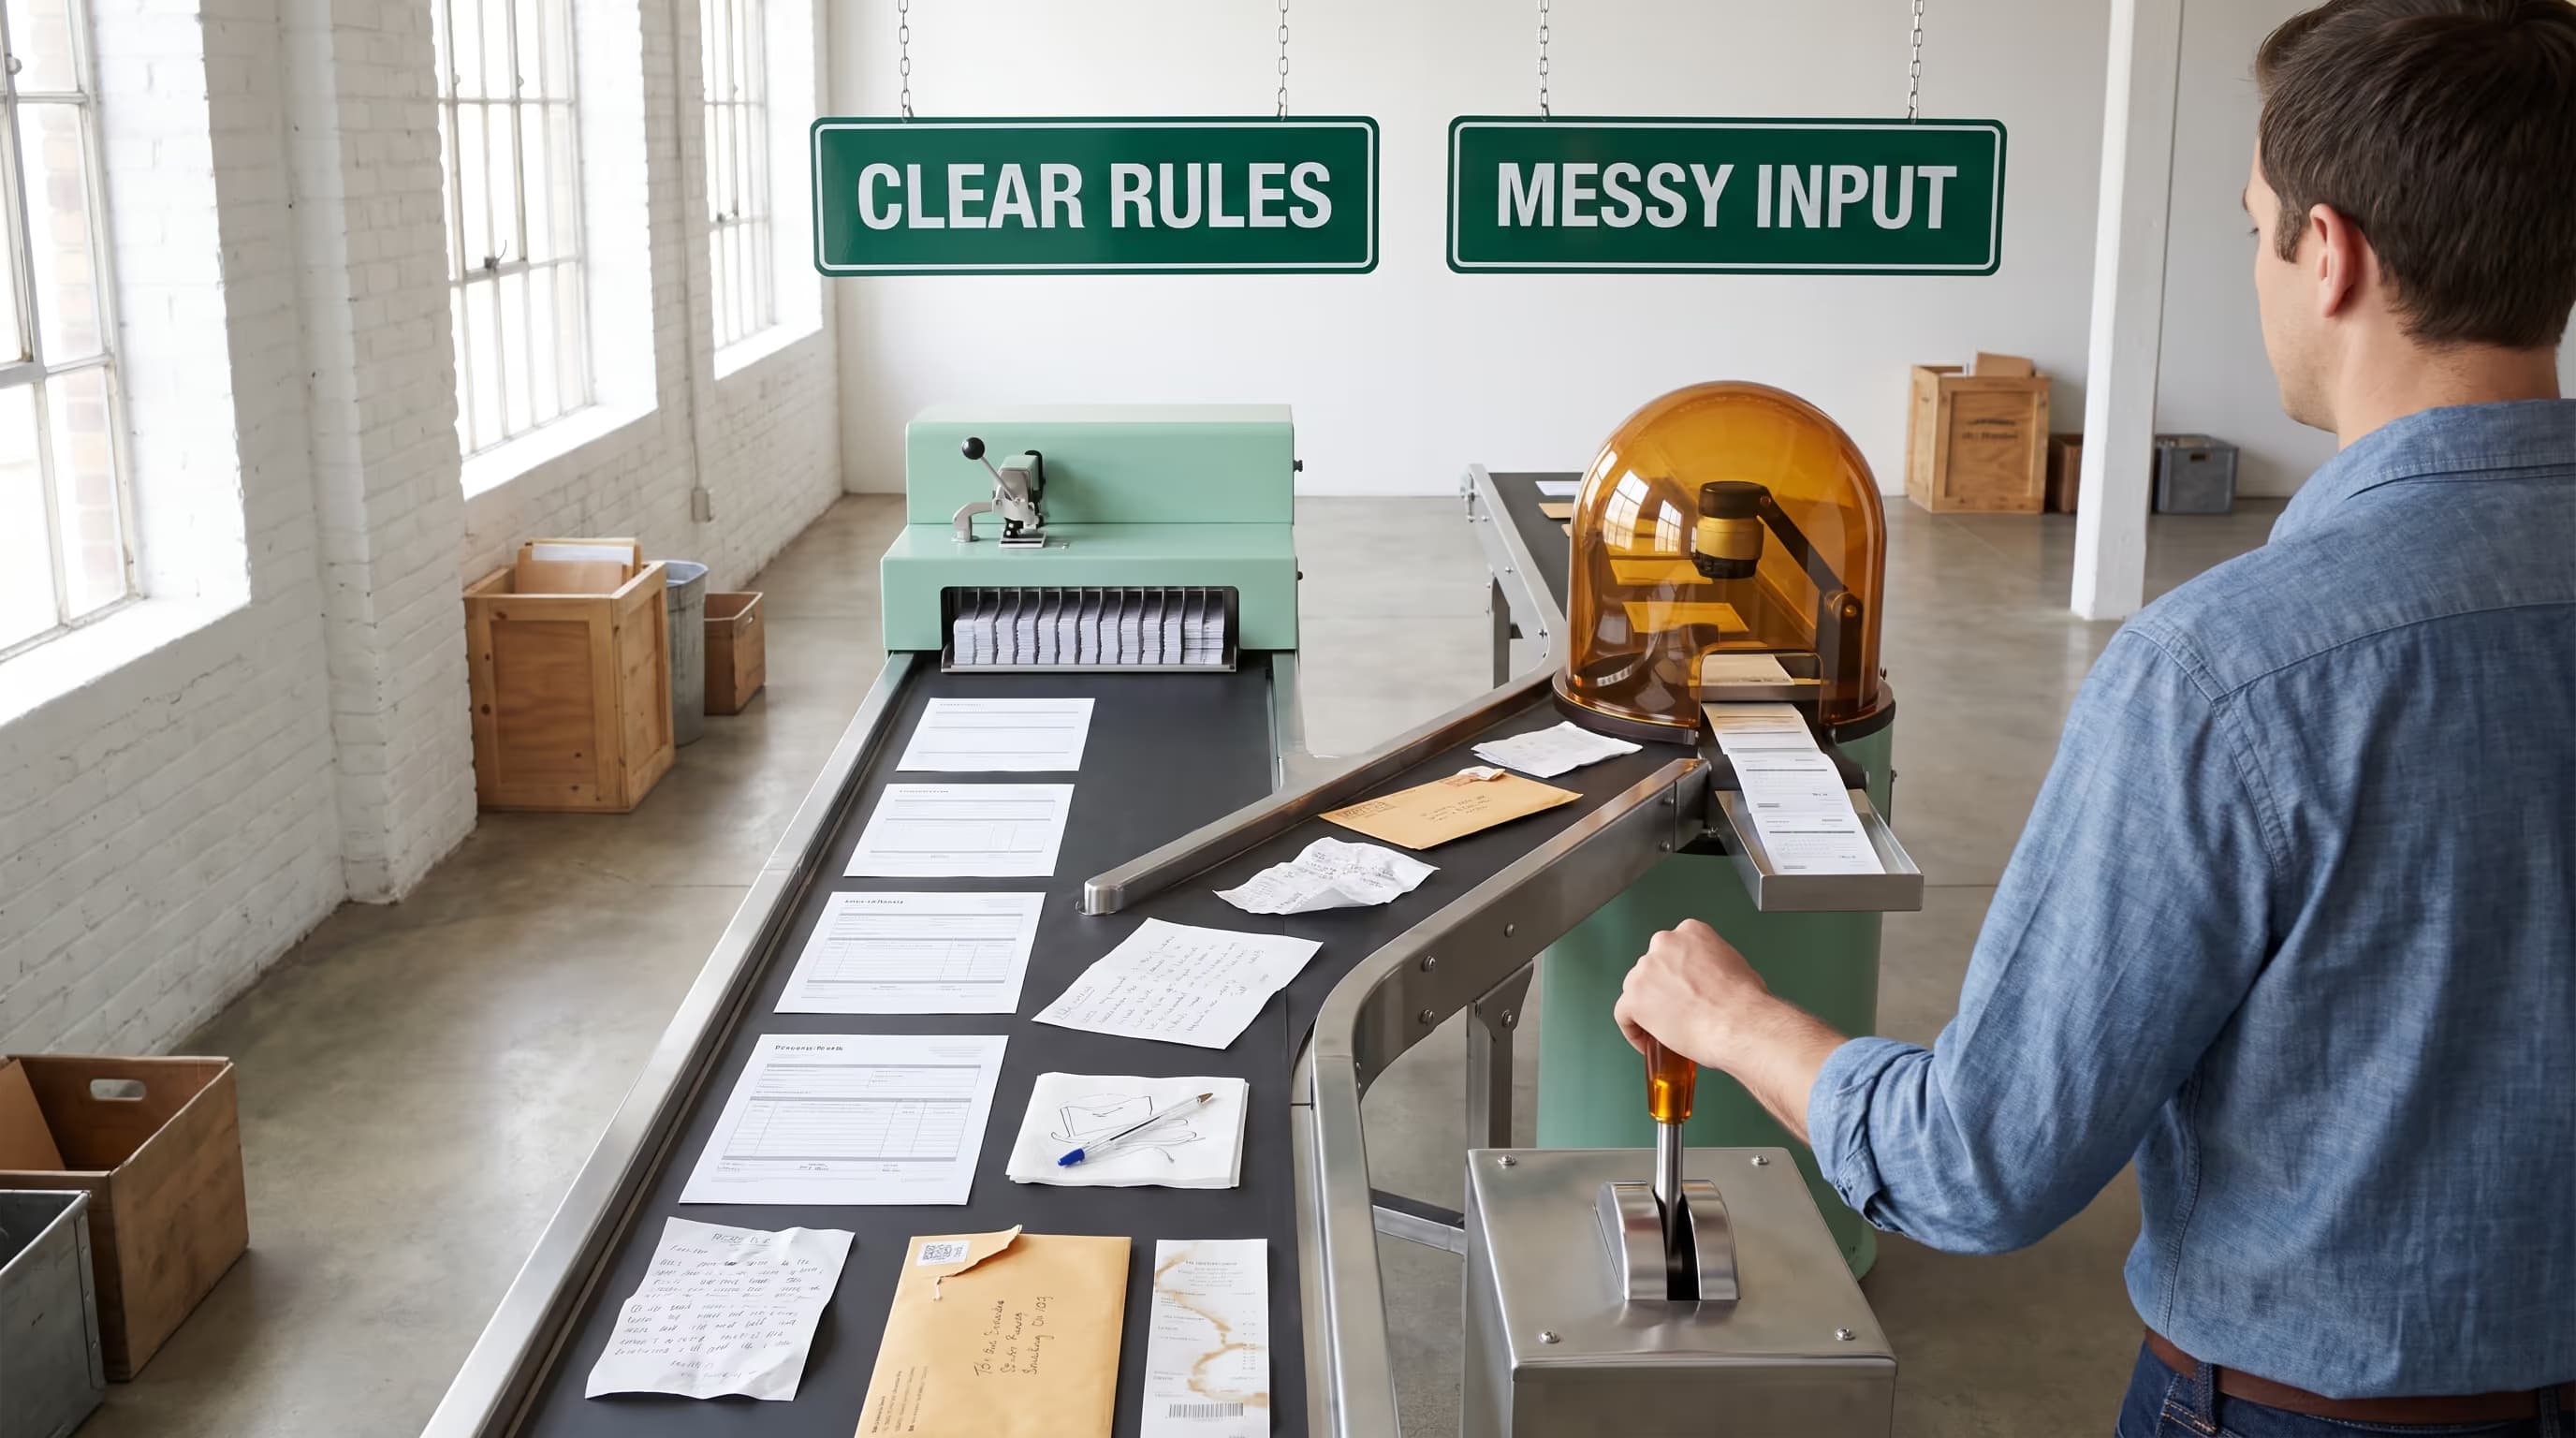
規則が明確なとき、通常の業務フローのほうが良い選択であることは少なくありません。フォーム、権限、検索、計算、通知、定期実行は、言語モデルが手元にあるからという理由だけでは必要になりません。
これは逆張りの主張ではありません。Googleの Rules of Machine Learning (新しいタブで開きます)、すなわちML技術者向けの社内指針は、率直な指示から始まります。「機械学習なしで製品を出すことを恐れるな」。
理由は、単純な経験則でも価値の多くはすでに取れるからです。機械学習が意味を持つのは、その経験則が絡まりすぎて保守できなくなってからです。
次の場合、従来型の業務フローのほうが良い答えになるのが普通です。
- 規則を書き出せて、その業務の責任者と合意できる
- 同じ入力が常に同じ出力を返すべきである
- 誤答の代償が大きく、正答が事前に分かりうる
- なぜシステムがそう動いたのかを、誰かが正確に説明する必要がある
- データがすでに構造化され、検証され、欠けがない
入力が乱雑で、予測しにくく、固定のルールでは捉えづらいとき、AIはその居場所を得ます。
- 長い文書、スレッド、通話メモを要約する
- 表現が大きく揺れる自由記述のメッセージを分類する
- 単一の書式に従わない文書から項目を抽出する
- 本人の代わりに決めるのではなく、情報の探索を助ける
- 人が確認して手を入れる前提の初稿を作る
二つめの一覧に共通するのは、人が流れの中に残っている点です。出力は最終判断ではなく、下書き、提案、出発点にとどまります。
こうした機能が最初に居場所を得るのは、たいていそこです。
正しい問いから始める
最初の問いは「どのモデルを使うか」ではありません。「利用者は何ができるべきか、そして不確かさは業務フローのどこで入り込むのか」と問いてください。その答えが、AIがプロダクトに属するかどうかを決めます。
作り始める前に、良い結果とはどういうものかを決めておきます。下書きの要約なら、人がざっと確認すれば十分かもしれません。ソフトウェアが自分で下す判断なら、より厳しい制御と、明確な説明と、安全に止めたり直したりする手段が要るかもしれません。
NISTの AI Risk Management Framework (新しいタブで開きます)、2023年1月に任意の指針として公開されたこの文書は、その点を明確に述べています。信頼に足るシステムの特性のうち、 妥当で信頼できること は「信頼性の必要条件」だとされています。
それは他の特性が乗る土台です。印象的でも信頼できない機能は、最初の一線を越えていません。
決める前に問うべきこと
誰かがAI機能を提案したとき、短い問いの一覧はたいてい、練られた計画と熱意だけの計画を分けてくれます。
- これは何をする作業で、AIなしならどうやるのか。
- 誤答は利用者に何を負わせ、誰が最初に気づくのか。
- この機能はどのデータを見て、それはどこへ行くのか。
- 公開前にどう検証し、公開後はどの頻度で検証するのか。
- モデルが使えないとき、あるいは確信が持てないとき、プロダクトは何をするのか。
- 現在の10倍の量になったとき、利用者1人あたり月いくらかかるのか。
どれも技術的な素養がなくても問えます。しかしどれも、それなしに説得力をもって答えるのは困難です。
人による確認を前提に設計する
人による確認は、あいまいな安全の合言葉ではありません。確認する人に、出力を検証できるだけの文脈と、手を入れる明確な方法と、プロダクトチームが追える不具合の報告経路を用意してください。
確立された枠組みが求めるのは、書面で示せる監督であって、やるつもりの監督ではありません。
NISTの枠組みの Map 機能は、「人による監督の手順が、組織の方針に沿って定義され、評価され、文書化される」ことを期待しています。
EUでは Article 14 of the AI Act (新しいタブで開きます) が、高リスク区分のシステムについて「使用されている期間を通じて自然人が実効的に監督できる」よう設計することを求めています。
すべてのプロダクトがその区分に入るわけではありません。それでもこの設計原則は、法的義務になるずっと前から妥当な既定値であり続けます。
セキュリティ側の指針も同じ見方です。 OWASP Top 10 for LLM Applications (新しいタブで開きます) は Excessive Agency を2025年のリスクの一つとして挙げています。
推奨される緩和策は直接的です。「影響の大きい操作は、実行前に人が承認するよう、人を介在させる制御を用いること」。
機能が自力で金銭を使い、メッセージを送り、記録を書き換えられるなら、その承認の一歩は開発の一部です。後回しの堅牢化作業ではありません。
作る前にデータの規則を決める
データへのアクセスとプライバシーは設計の一部でなければなりません。この機能がどの情報を受け取り、どこで処理され、どれだけ保持され、誰または何のシステムが結果に触れてよいのかを特定してください。
OWASPは Sensitive Information Disclosure (新しいタブで開きます) を2025年のLLMリスクの第2位に置いています。その指針は、多くのチームが知っていながら納期に追われて省く規則に集約されます。「最小権限の原則に基づき、機微なデータへのアクセスを制限すること」。
モデルは利用者の情報に触れるもう一つのシステムであり、そのように範囲を絞るべきです。
各社は具体的な条件を公開しており、その違いは無視できません。設計を固める前に読む価値のあるものが三つあります。
- 学習への利用。 OpenAIの データ管理に関する文書 (新しいタブで開きます) には「OpenAI APIに送信されたデータはOpenAIのモデルの学習や改善には使用されない」と記されており、不正利用の監視のための保持期間は別に定められています。
- 保持。 Anthropicの データ保持に関する文書 (新しいタブで開きます) は、ゼロデータ保持を、応答が返された後にプロンプトと応答が保存されない状態として説明しています。同社の対象一覧は状態を持つ機能を例外として示しており、ゼロ保持は一律ではありません。
- 推論が動く場所。 地域は設定でき、料金も別に定められています。Anthropicの データ所在地に関する文書 (新しいタブで開きます) は、米国内のみでの推論が「標準料金の1.1倍で課金される」と記しています。
プロダクトがEU域内の人の個人データを扱うなら、設計段階での義務は明文化されています。
欧州委員会の データ保護バイデザイン・バイデフォルトに関する指針 (新しいタブで開きます) は、組織が既定で「個人データを最高水準のプライバシー保護のもとで処理することを確保すべきである」と述べています。
それは統合の前に下す判断であって、事故の後に下すものではありません。
利用者1人あたりの費用を見積もる
最初の実験が安かったからといって、ホスト型のAIサービスが無料だと考えないでください。利用量、保存、監視、再試行、確認にかかる時間、将来のモデル変更は、どれも運用費に効いてきます。
AI提供各社は処理した文字量に対して課金するのが一般的です。つまり費用は人数ではなく利用量とともに増えます。
その要因は各社自身の 料金に関する文書 (新しいタブで開きます)に挙げられています。モデルの選択、プロンプトのキャッシュ、ツール呼び出しにともなうトークンの上乗せ、そしてバッチ処理です。AnthropicのBatch APIは非同期の処理に対して「入力・出力トークンの双方で50%の割引」を提供しています。
通常料金では割に合わない機能も、その処理が即時である必要がないなら成り立つことがあります。
セキュリティの側面もあります。OWASPの Unbounded Consumption (新しいタブで開きます) の項目は、「大量の処理を起こすことで、攻撃者はクラウド型AIサービスの従量課金モデルを悪用する」と説明しています。
これはときに denial of wallet と呼ばれます。レート制限、割当、利用量の監視は、二番目ではなく最初のリリースに属します。
まず実例で検証する
機能が完成したと言う前に、小さなテスト集合を作ってください。代表的な例を使い、難しい事例を含め、そのプロダクトを使う人にとって重要な誤りの種類を記録します。
主要な二社とも、これを後から足すものではなく、最初にやることとして扱っています。
Anthropicの 実証的な評価の作り方に関する指針 (新しいタブで開きます) は、役に立つ集合の形について具体的です。「作業に固有であること。実際の作業分布を映した評価を設計してください。端の事例を織り込むのを忘れずに」。
OpenAIの 評価に関する手引き (新しいタブで開きます) は、同じ実践を、アプリケーションが期待に対してどう振る舞うかを理解することとして位置づけています。それがモデルやプロンプトの変更を安全に出せるものにします。
役に立つ評価は、あらゆる応答を予測する必要はありません。その機能が目的の作業に有用かどうか、どこで失敗するか、そして業務フローがいつ人に制御を返すべきかを示せれば十分です。
評価は公開で終わるものでもありません。Microsoftの 可観測性に関する指針 (新しいタブで開きます) は、「本番トラフィックの品質と安全性を標本抽出の割合で評価する」ことを含め、ライフサイクルが本番運用へ続くと説明しています。
実際の利用には、テスト集合が想像もしなかった入力が含まれます。
代替動作を決めておく
代替動作にも実務的な設計が要ります。モデルが使えない、遅すぎる、確信が持てないときでも、空の画面や誤解を招く答えを残すのではなく、利用者が次に何をできるのかを示すべきです。
三つの場面について、機能が何をするかを事前に決めてください。モデルが使える結果を返さないとき、要求が時間切れになったとき、そして確信度が低いときです。
どれも利用者に見える帰結を持つプロダクトの判断です。そしてどれも、障害の最中より今のほうが安く決められます。
後からどれだけ容易にモデルや提供元を変えられるかも、決めておく価値があります。プロンプト、評価集合、そしてプロダクトとモデルのあいだの薄い境界を保つことが、その選択肢を残します。
具体例で考える
具体的に考えるために、受信メールに溺れているサポートチームを想像してください。すべてのメッセージを読み、分類し、適切な担当者へ回す必要があり、量は担当者の手に余っています。
最初の衝動は、各メールを読んで返信するAIエージェントに手を伸ばすことです。その前に、先ほどの問いを通してみてください。
作業は何で、AIなしならどうやるのか。 キーワードと送信者による振り分けは、明確な事例をすでに処理できています。難しいのは曖昧な自由記述のメッセージ——まさにモデルに向いた形です。
誤答は何を招くのか。 誤配のメールは数分の損失です。返金規定を勝手に作り出す自動返信は、はるかに高くつきます。だから安全な初版は分類と下書きを提案し、送信は人が行います。
どう検証するのか。 すでに解決済みのメール数百通が評価集合になります。乱雑なものや例外的なものを意図的に含めます。提案された分類が読む時間を節約できる程度に当たるなら、その機能は居場所を得ます。
公開される機能は狭いものになります。分類と下書き、送信は人、キーワード規則は明白な事例を担当し続け、すべてが記録されて評価集合が育っていきます。
それはチームが最初に思い描いたエージェントより小さく、安全で、安価なプロダクトです。そして実際の受信箱との接触を生き延びる可能性が高いのもこちらです。
何を作るかを決める
AIを使って作ることと、AIを中に入れて出荷することは、別々の判断です。開発者はコードを書くときにAIツールを使いながら、普通のソフトウェアで動く製品も、AI機能を使う製品も、その両方の製品も届けられます。
新しいプロダクトでは、まず最小の有用な業務フローを決めてください。AI機能を加えるのは、それが定義された利用者にとってその流れを良くし、チームが維持できる根拠で検証できるときだけです。
最も強いAIプロダクト計画は、境界について具体的です。機能が約束になる前に、作業、データ、確認者、代替動作、評価方法、費用の前提を名指しします。
AIか、自動化か、受託開発かを比べているなら、その判断を計画の会話の早い段階に持ち込んでください。正解はAIかもしれませんし、規則ベースの業務フローかもしれませんし、新しい技術を使わないことかもしれません。
次の記事を受け取る
新しい記事が公開されたときにメールを1通。それだけです。
プライバシーを尊重します。配信はいつでも停止できます。
ディスカッション
コメント
まだコメントはありません。最初のひとことをどうぞ。