Menu
Il tuo prodotto deve usare l’IA? Una guida pratica

Muhammad Saeed
Software engineer
19 lug 2026
11 min di lettura
Una guida pratica per fondatori che scelgono tra IA, automazione e software standard, con domande su dati, privacy, test, costi e revisione umana.
Contenuti10 sezioni
L’IA può essere utile in un prodotto, ma «aggiungere l’IA» non è un requisito di prodotto. Parti dal problema dell’utente, dalla decisione che il software deve sostenere e dal costo di sbagliare quella decisione.
La pressione ad adottarla è reale, e lo è anche il divario che ci sta dietro.
L’2026 AI Index (si apre in una nuova scheda) di Stanford HAI riporta che l’adozione dell’IA nelle organizzazioni è salita all’88 % delle organizzazioni intervistate nel 2025. Osserva anche che l’uso di agenti IA «resta agli inizi» in quasi tutte le funzioni aziendali.
Lo studio 2026 State of AI in the Enterprise (si apre in una nuova scheda) di Deloitte ha intervistato 3.235 dirigenti in 24 Paesi. Ha rilevato che il 74 % delle organizzazioni spera di aumentare i ricavi con l’IA, contro il 20 % che già lo fa.
L’adozione è quasi universale. Il valore realizzato no.
Quel divario è la ragione per rallentare il tempo di una conversazione prima di impegnarsi. La domanda non è se l’IA sia capace. È se questa funzionalità, per questo utente, corrisponda a un problema della forma giusta per l’IA.
Quando l’IA è adatta e quando no
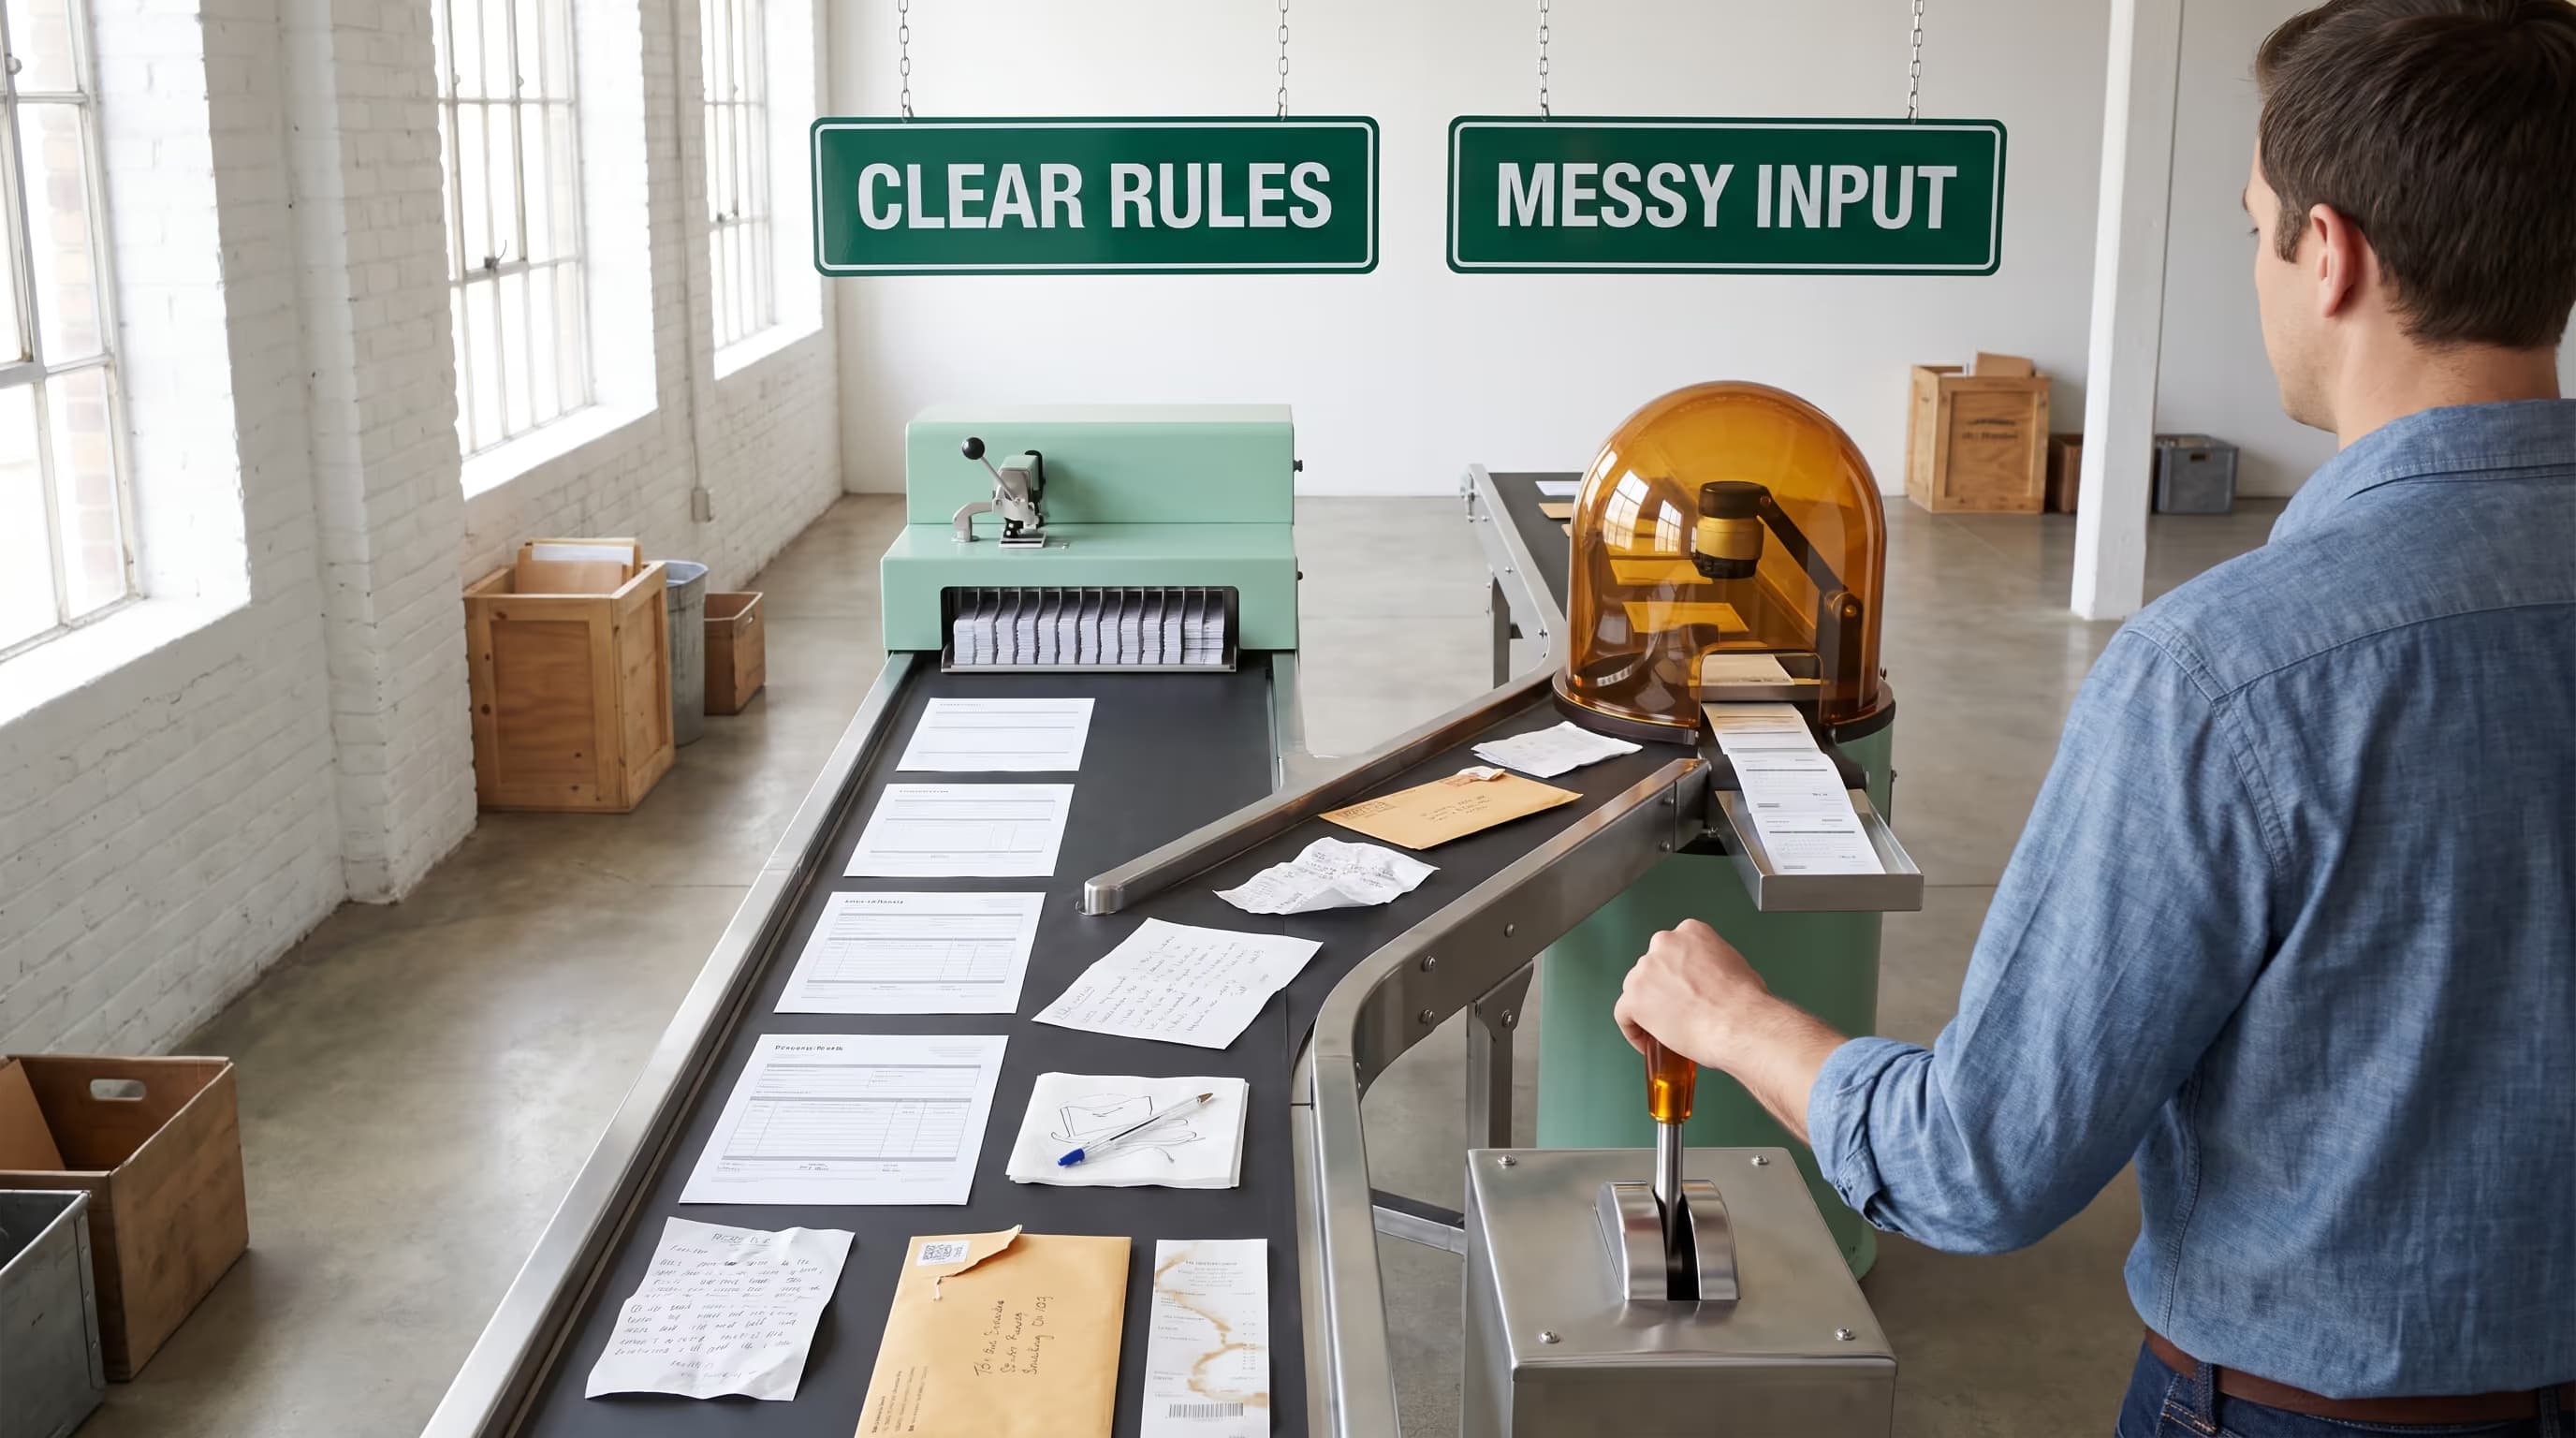
Un flusso di lavoro normale è spesso la scelta migliore quando le regole sono chiare. Moduli, permessi, ricerca, calcoli, notifiche e attività pianificate non hanno bisogno di un modello linguistico solo perché ne esiste uno.
Non è una posizione controcorrente. Le Rules of Machine Learning (si apre in una nuova scheda), la guida interna di Google per gli ingegneri ML, si aprono con un’istruzione diretta: «Non aver paura di lanciare un prodotto senza machine learning».
Il ragionamento è che una regola semplice cattura già buona parte del valore. Il machine learning si guadagna il suo posto quando quelle regole diventano troppo intricate da mantenere.
Un flusso di lavoro convenzionale è di solito la risposta migliore quando:
- le regole si possono scrivere e concordare con chi è responsabile del processo
- lo stesso input deve produrre sempre lo stesso output
- il costo di una risposta sbagliata è alto e quella giusta è conoscibile in anticipo
- qualcuno deve poter spiegare con precisione perché il sistema ha fatto quello che ha fatto
- i dati sono già strutturati, validati e completi
L’IA si guadagna il suo posto quando l’input è disordinato, imprevedibile o difficile da inquadrare con regole fisse:
- riassumere documenti lunghi, conversazioni o note di chiamata
- classificare messaggi in testo libero la cui formulazione varia molto
- estrarre campi da documenti che non seguono mai un unico modello
- aiutare una persona a esplorare informazioni invece di decidere al posto suo
- redigere una prima versione che un umano rivedrà e modificherà
Il tratto comune del secondo elenco è che una persona resta nel ciclo. L’output è una bozza, un suggerimento o un punto di partenza, non una decisione finale.
È di solito lì che queste funzionalità si guadagnano per prime il loro posto.
Parti dalla domanda giusta
La prima domanda non è «quale modello usiamo?». Chiedi piuttosto: «che cosa deve poter fare l’utente e dove entra l’incertezza nel flusso di lavoro?». Quella risposta decide se l’IA appartenga al prodotto.
Decidi come si presenta un buon risultato prima di costruire. Una bozza di sintesi può bastare con un controllo umano rapido. Una decisione che il software prende da solo può richiedere controlli più stretti, una spiegazione chiara e un modo sicuro per fermarla o correggerla.
L’AI Risk Management Framework (si apre in una nuova scheda), pubblicato nel gennaio 2023 come guida volontaria del NIST, lo dice chiaramente. Tra le sue caratteristiche dei sistemi affidabili, essere valido e affidabile è «una condizione necessaria dell’affidabilità».
È la base su cui poggiano le altre caratteristiche. Una funzionalità impressionante ma inaffidabile non ha superato la prima asticella.
Domande da porre prima di impegnarti
Se qualcuno propone una funzionalità con IA, un breve elenco di domande tende a separare un piano ponderato da uno entusiasta:
- Che compito svolge, e come lo faremmo senza IA?
- Quanto costa all’utente una risposta sbagliata, e chi se ne accorge per primo?
- Quali dati vede la funzionalità, e dove finiscono?
- Come la testeremo prima del lancio, e con quale frequenza dopo?
- Che cosa fa il prodotto quando il modello non è disponibile o non è sicuro?
- Quanto costa per utente al mese a dieci volte il volume attuale?
Nessuna di queste richiede una formazione tecnica per essere posta. Tutte sono difficili da risolvere in modo convincente senza.
Progetta per la revisione umana
La revisione umana non è una formula vaga di sicurezza. Dai a chi rivede abbastanza contesto per verificare l’output, un modo chiaro di modificarlo e una via per segnalare un guasto che il team di prodotto possa indagare.
I framework consolidati chiedono una supervisione che puoi mostrare per iscritto, non una che hai intenzione di fare.
La funzione Map del framework NIST si aspetta che «i processi di supervisione umana siano definiti, valutati e documentati in conformità con le politiche dell’organizzazione».
Nell’UE, Article 14 of the AI Act (si apre in una nuova scheda) richiede che i sistemi della sua categoria ad alto rischio siano progettati in modo «che possano essere efficacemente sorvegliati da persone fisiche durante il periodo in cui sono in uso».
Non tutti i prodotti rientrano in quella categoria. Il principio di progettazione resta un’impostazione ragionevole molto prima di diventare un obbligo di legge.
Le linee guida di sicurezza concordano. L’OWASP Top 10 for LLM Applications (si apre in una nuova scheda) elenca Excessive Agency tra i suoi rischi del 2025.
La mitigazione raccomandata è diretta: «usa un controllo con intervento umano per richiedere che una persona approvi le azioni ad alto impatto prima che siano eseguite».
Se una funzionalità può spendere denaro, inviare messaggi o modificare record da sola, quel passaggio di approvazione fa parte della costruzione. Non è un lavoro di irrobustimento successivo.
Fissa le regole sui dati prima di costruire
Accesso ai dati e privacy devono far parte della progettazione. Individua quali informazioni riceve la funzionalità, dove vengono elaborate, per quanto tempo sono conservate e quali persone o sistemi possono accedere al risultato.
OWASP colloca Sensitive Information Disclosure (si apre in una nuova scheda) al secondo posto tra i suoi rischi LLM del 2025. La sua guida si riduce a una regola che quasi tutti i team conoscono e saltano sotto scadenza: «limita l’accesso ai dati sensibili in base al principio del privilegio minimo».
Il modello è un sistema in più con accesso alle informazioni dei tuoi utenti, e andrebbe delimitato come tale.
I fornitori pubblicano condizioni concrete, e differiscono abbastanza da contare. Tre meritano una lettura prima che il progetto sia fissato:
- Uso per l’addestramento. La documentazione di OpenAI sui controlli dei dati (si apre in una nuova scheda) afferma che «i dati inviati all’API di OpenAI non sono usati per addestrare o migliorare i modelli di OpenAI», con una finestra di conservazione separata per il monitoraggio degli abusi.
- Conservazione. La documentazione di Anthropic sulla conservazione dei dati (si apre in una nuova scheda) descrive la conservazione zero come il fatto che prompt e risposte non sono memorizzati a riposo dopo il ritorno della risposta. La sua tabella di idoneità segna come eccezioni le funzionalità con stato, quindi la conservazione zero non è generalizzata.
- Dove gira l’inferenza. La geografia è configurabile e tariffata a parte. La documentazione di Anthropic sulla residenza dei dati (si apre in una nuova scheda) nota che l’inferenza solo negli Stati Uniti «è tariffata a 1,1 volte la tariffa standard».
Se il prodotto tratta dati personali di persone nell’UE, l’obbligo in fase di progettazione è esplicito.
Gli orientamenti della Commissione europea sulla protezione dei dati fin dalla progettazione e per impostazione predefinita (si apre in una nuova scheda) affermano che le organizzazioni «dovrebbero garantire che i dati personali siano trattati con il massimo livello di protezione della vita privata» per impostazione predefinita.
È una decisione presa prima dell’integrazione, non dopo l’incidente.
Pianifica il costo per utente
Non dare per scontato che un servizio IA in hosting sia gratuito perché il primo esperimento costa poco. Utilizzo, archiviazione, monitoraggio, tentativi ripetuti, tempo di revisione e futuri cambi di modello incidono tutti sul costo operativo.
I fornitori di IA di solito fatturano la quantità di testo elaborata, così il costo cresce con l’uso anziché con il numero di persone.
Le leve sono nominate nella stessa documentazione tariffaria dei fornitori (si apre in una nuova scheda): scelta del modello, caching dei prompt, token aggiuntivi delle chiamate agli strumenti e batching. L’API Batch di Anthropic offre «uno sconto del 50 % sui token di input e di output» per il lavoro asincrono.
Una funzionalità non sostenibile a prezzo pieno può andare bene quando il lavoro non deve essere immediato.
C’è anche una dimensione di sicurezza. La voce Unbounded Consumption (si apre in una nuova scheda) di OWASP descrive come «avviando un volume elevato di operazioni, gli attaccanti sfruttano il modello di costo per utilizzo dei servizi IA in cloud».
A volte lo si chiama denial of wallet. Limiti di frequenza, quote e monitoraggio dell’uso appartengono alla prima release, non alla seconda.
Prova prima con esempi reali
Costruisci un piccolo set di test prima di dichiarare pronta la funzionalità. Usa esempi rappresentativi, includi i casi difficili e registra i tipi di errore che contano per chi userà il prodotto.
Entrambi i grandi fornitori lo trattano come qualcosa da fare prima, non da aggiungere dopo.
Gli orientamenti di Anthropic sullo sviluppo di valutazioni empiriche (si apre in una nuova scheda) sono precisi sulla forma di un set utile: «sii specifico rispetto al compito: progetta valutazioni che rispecchino la distribuzione reale dei tuoi compiti. Non dimenticare di tenere conto dei casi limite!».
La documentazione di OpenAI sulle valutazioni (si apre in una nuova scheda) inquadra la stessa pratica come capire come si comporta un’applicazione rispetto alle aspettative. È ciò che rende sicuro rilasciare un cambio di modello o di prompt.
Una valutazione utile non deve prevedere ogni risposta. Deve mostrare se la funzionalità è utile per il suo compito, dove fallisce e quando il flusso di lavoro deve restituire il controllo a una persona.
Nemmeno la valutazione si ferma al lancio. Gli orientamenti di Microsoft sull’osservabilità (si apre in una nuova scheda) descrivono un ciclo di vita che prosegue in produzione con «valutazione di qualità e sicurezza del traffico di produzione a un tasso di campionamento».
L’uso reale conterrà input che il tuo set di test non ha mai immaginato.
Pianifica il ripiego
Anche un ripiego ha bisogno di una progettazione pratica. Se il modello non è disponibile, è troppo lento o è incerto, il prodotto deve comunque spiegare che cosa può fare l’utente dopo, invece di lasciare uno stato vuoto o una risposta fuorviante.
Decidi in anticipo che cosa fa la funzionalità in tre situazioni: quando il modello non restituisce nulla di utilizzabile, quando la richiesta va in timeout e quando la confidenza è bassa.
Ognuna è una decisione di prodotto con conseguenze visibili per l’utente. Ognuna costa meno ora che durante un incidente.
Vale anche la pena decidere con quanta facilità potresti cambiare modello o fornitore in seguito. Conservare prompt, set di valutazione e un’interfaccia sottile tra prodotto e modello preserva quell’opzione.
Un esempio concreto
Per renderlo concreto, immagina un team di assistenza sommerso dalle email in arrivo. Ogni messaggio va letto, categorizzato e instradato alla persona giusta, e il volume ha superato le persone che se ne occupano.
L’istinto è ricorrere a un agente IA che legga ogni email e risponda. Passa invece per le domande.
Qual è il compito, e come lo faremmo senza IA? L’instradamento per parola chiave e mittente copre già i casi chiari. La parte difficile sono i messaggi ambigui in testo libero: proprio la forma adatta a un modello.
Quanto costa una risposta sbagliata? Un’email instradata male costa minuti. Una risposta automatica che inventa una politica di rimborso costa molto di più. Perciò la prima versione sicura suggerisce una categoria e una bozza; a inviare è ancora una persona.
Come la testeremo? Qualche centinaio di email già risolte diventa il set di valutazione, includendo di proposito quelle disordinate e insolite. Se la categoria suggerita è giusta abbastanza spesso da far risparmiare tempo di lettura, si guadagna il posto.
La funzionalità che viene rilasciata è stretta: classificare e redigere, invia una persona, le regole per parola chiave gestiscono ancora i casi ovvi, e tutto viene registrato perché il set di valutazione continui a crescere.
È un prodotto più piccolo, più sicuro e meno costoso dell’agente immaginato all’inizio, e quello con più probabilità di sopravvivere al contatto con caselle di posta reali.
Decidere che cosa costruire
Usare l’IA per costruire qualcosa e spedire l’IA dentro il prodotto sono due decisioni diverse. Chi sviluppa può usare strumenti di IA mentre scrive il codice e consegnare comunque un prodotto che gira su software normale, su funzioni di IA, o su entrambi.
Per un prodotto nuovo, decidi prima il flusso di lavoro utile più piccolo. Aggiungi una funzionalità IA solo quando migliora quel flusso per un utente definito e può essere testata con prove che il team sappia mantenere.
Il piano di prodotto IA più solido è preciso sui propri confini. Nomina il compito, i dati, chi rivede, il ripiego, il metodo di valutazione e le ipotesi di costo prima che la funzionalità diventi una promessa.
Se stai valutando l’IA contro l’automazione o il software su misura, porta la decisione presto nella conversazione di pianificazione. La risposta giusta può essere l’IA, un flusso basato su regole o nessuna nuova tecnologia.
Ricevi il prossimo articolo
Un’e-mail quando esce un nuovo articolo. Nient’altro.
Rispetto la sua privacy. Può disiscriversi quando vuole.
Discussione
Commenti
Ancora nessun commento. Scrivi tu il primo.